









微帧AI大模型平台是一个统一接入主流文本、图片和视频模型的API平台。你不需要分别维护不同厂商的账户、API Key、计费系统和接口,通过一个API Key和一个计费账户即可调用平台支持的模型。
突破编码极限,实现超高压缩效率


WZ264视频智能编码


WZ265视频智能编码


Aurora-AV1视频智能编码

Resolution: 1920x1080
Bitrate:3455 kbps

Resolution: 1920x1080
Bitrate:1600 kbps
编码节约
为什么选择微帧视频智能编码引擎?
同类产品
No.1
优于市场其他同类产品
码率节省约
50%
更高压缩率
VMAF分数高于
95+
更优质的画面
服务头部客户
200+
广受业界好评
节省成本约
50%
大幅省带宽/存储成本
比开源编码器快
3.2 倍
更快的编码速度
产品亮点
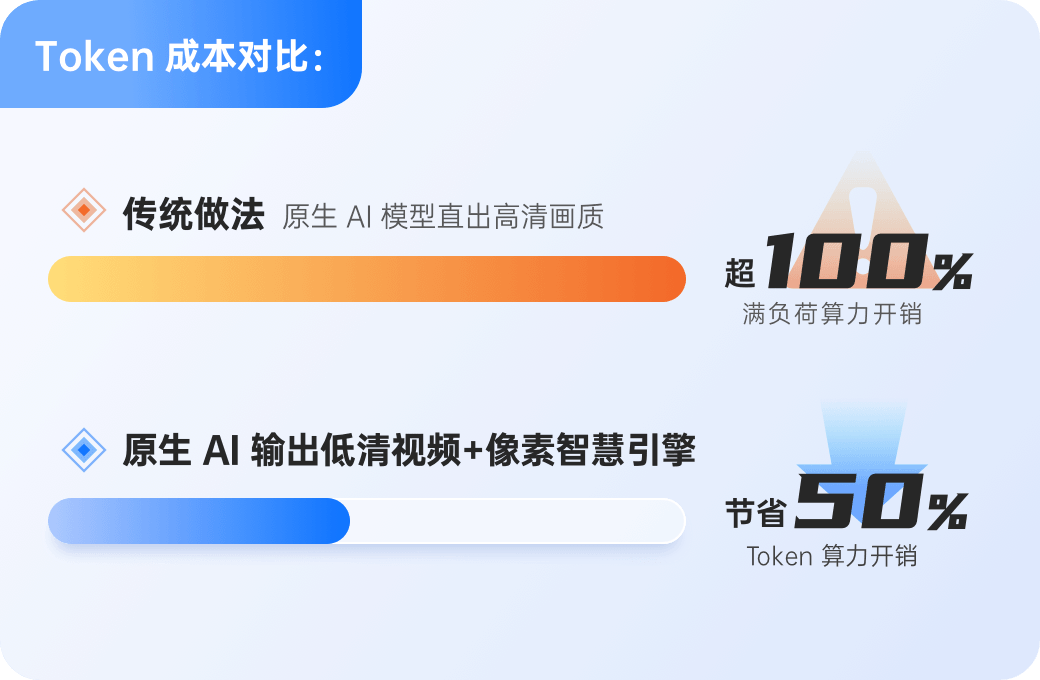
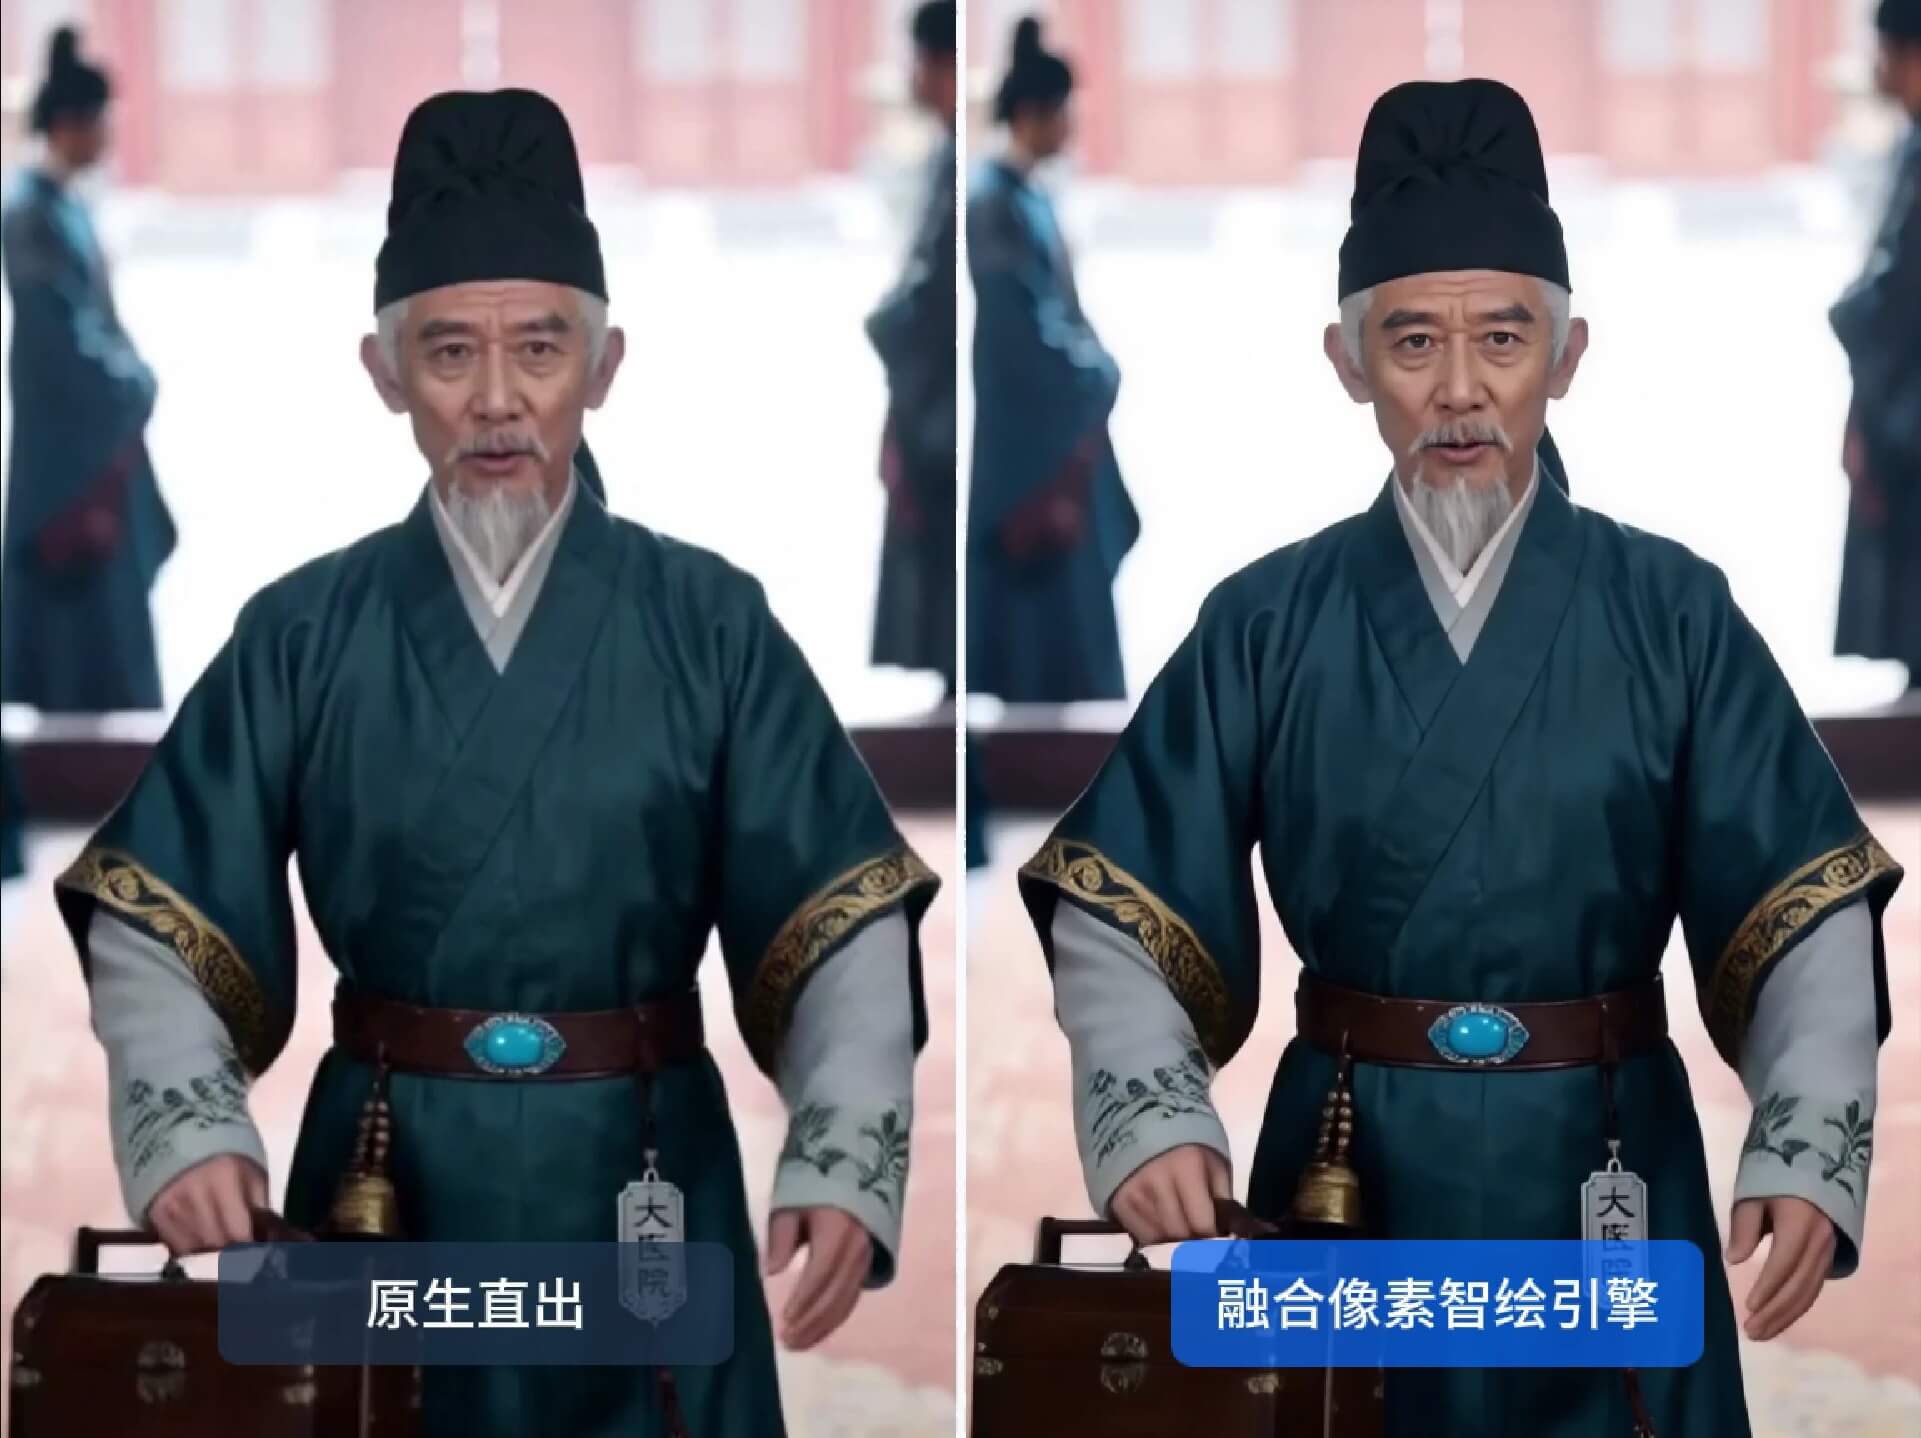
无需在原生AI模型中直接生成计算量过大的高清画面。仅需驱动大模型生成低清初稿(例如 480P),后续极清解析度和质感还原全部交由像素智绘引擎,将 Token 综合消耗减至 50%。
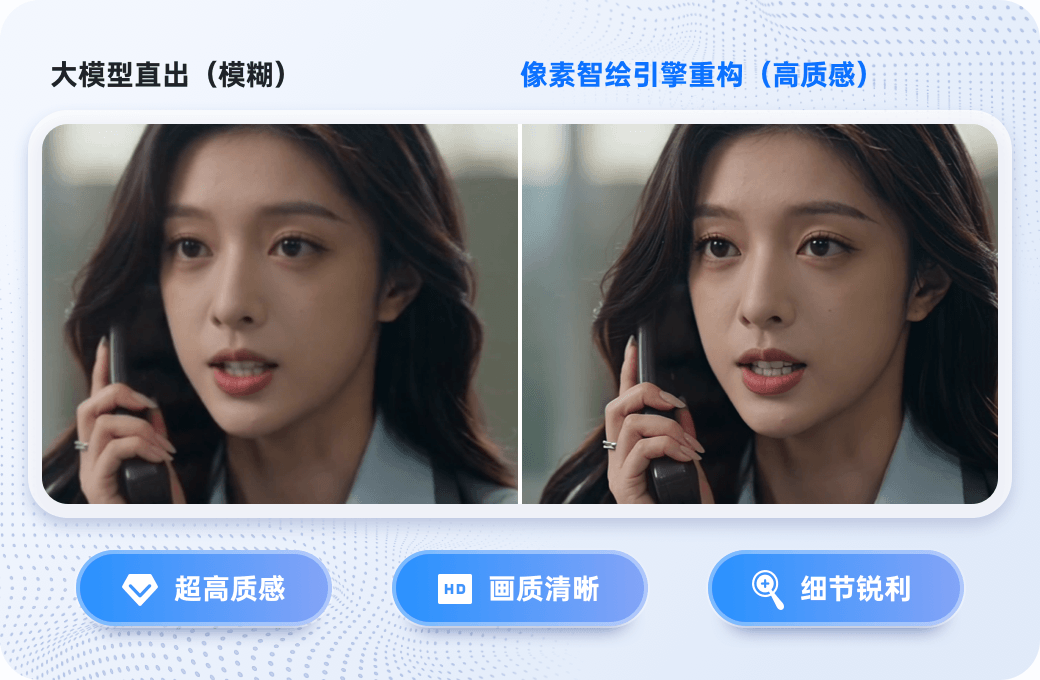
针对原生低分素材存在物体与文字边缘锯齿重、细节模糊等短板,像素智绘引擎依托低分 + 增强专属链路,实现低分素材无损超分,原生输出高清画面。

基于 AIGC 图像原生微米结构算法,针对性深度修复失真的皮肤纹理与发丝边缘细节,复刻真人质感。
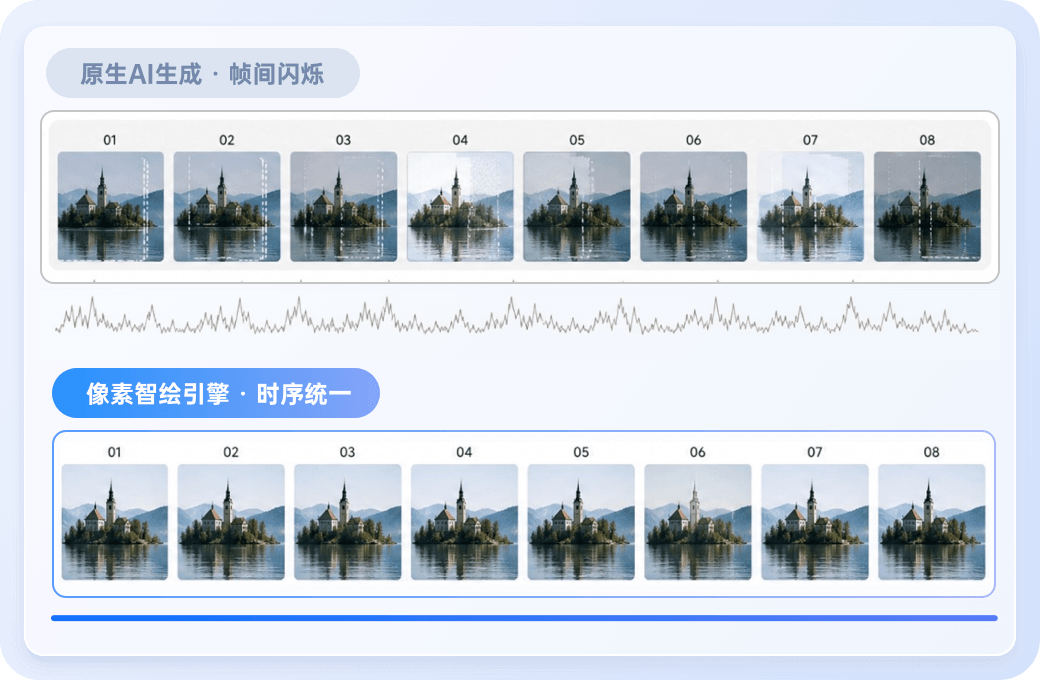
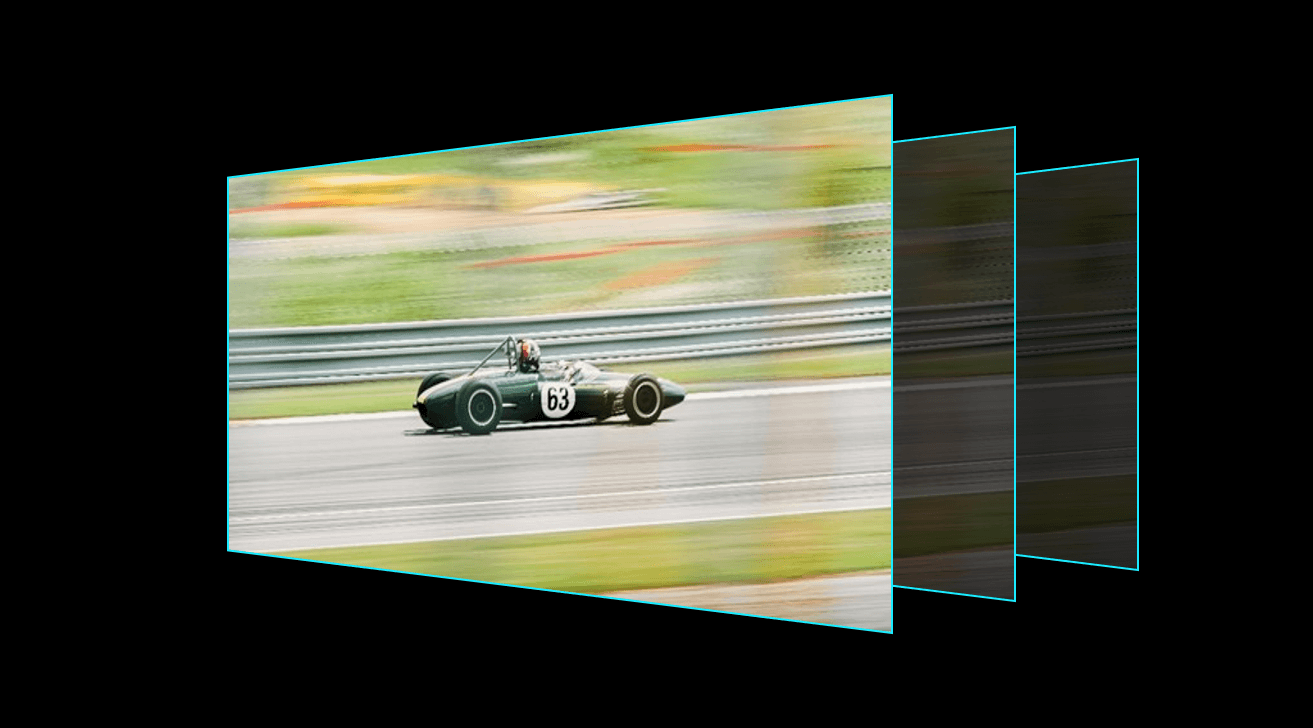
独有跨帧特征匹配技术,底层统一全帧特征空间。在保证视频动态不失真的前提下,智能抑制画面漂移闪烁,后期人工维护成本直线下降。

 业务适配广泛
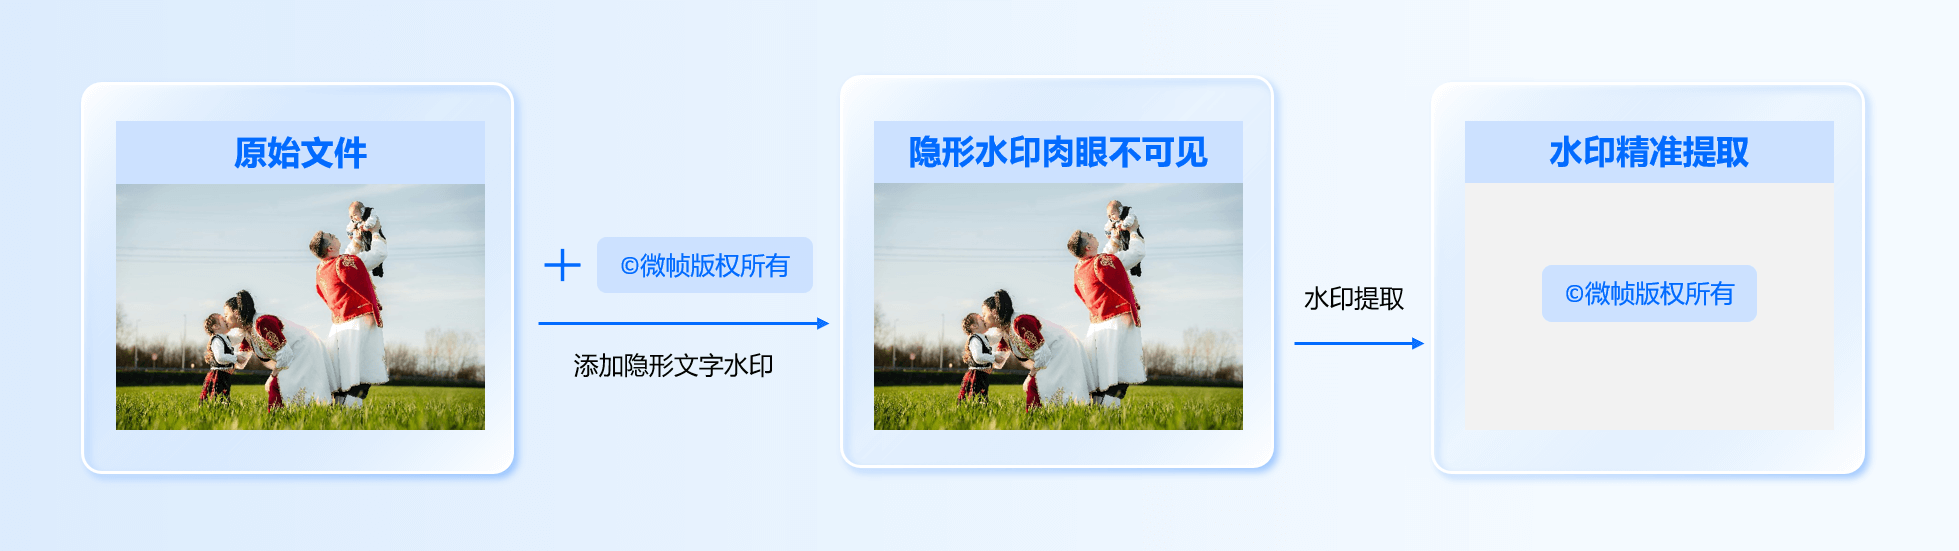
既能支撑版权保护、侵权追溯,助力原创者维权,也能满足平台视频查重、违规视频快速审核的需求。

 大幅降本
替代人工完成视频查重、违规内容筛查、广告监播等大量重复性工作,减少人工成本与时间成本。

 超高压缩率
极致压缩算法突破编码能力上限,对比行业同类编码产品,相同画质下视频码率减小30%~50%。

 央视频
“央视频”(China Media Group Mobile)是中央广播电视总台基于5G+4K/8K+AI等新技术推出的综合性视听新媒体旗舰平台,也是中国首个国家级5G新媒体平台,于2019年11月20日正式上线,为用户带来了全新视听体验。央视联合微帧在实时直播画质增强方向进行了深度技术探索及合作,如在亚运会、戏曲春晚等大型直播活动中,提供画质增强技术支持,让观众第一时间身临其境感受赛事精彩瞬间。

 智能高清
支持H.264、H.265、AV1编码,业内领先的智能高清转码技术,同等视频质量下比普通转码节省40%以上的带宽成本。

 卓越H.264编码内核
全球领先的H.264编码方案,世界范围内极少数基于H.264标准的自研编码内核,编码性能卓越

 领先的AV1编码内核
全球首家落地应用的AV1软件编码器,技术领先,连续多次获得世界级编码大赛MSU大赛冠军。

 视觉无感
人眼完全无法察觉,不改变视频、图片的色彩、清晰度和整体观感,既能藏好标识信息,又不影响用户对原内容的观看体验。

 抗攻击能力强
面对视频、图片常见的修改操作都能保持水印稳定,如裁剪、旋转、缩放、添加噪声、格式转换等,水印仍能被准确提取,避免侵权者通过修改内容规避追踪。

 安全可靠
具备抗伪造能力,避免不法分子通过技术手段替换原有水印,确保水印与内容的绑定关系不可篡改,保障版权验证、责任认定等场景的有效性。

 指纹特性极致可靠
具备绝对唯一性,提取的视频指纹能精准区分不同视频,不会出现特征混淆的情况,可实现对每个视频的唯一标记。

 高稳定性
即便视频经过剪辑拼接、格式转换、压缩或旋转等常见修改操作,其核心 DNA 特征也不会改变,能稳定锁定目标视频。

 识别准确率高
在识别中保持着零误判记录,对加字幕、调分辨率等变换后的视频,识别准确率也能达到 99% 以上。

 保障数据安全
产品存储的仅为视频 DNA 信息,无法通过这些信息反推出完整视频内容,能保障视频原始数据安全。

 超高精度识别
精准区分正常与涉黄、暴力、恐怖等违禁画面,即使画面存在模糊、变形、遮挡或使用滤镜特效等干扰因素,也能通过对图像特征的深度挖掘与比对,准确判断其合规性。

 实时审查
可在视频播放或上传的瞬间,实时对视频内容进行逐帧、逐秒分析,并迅速给出审查结果。

 灵活定制审查
根据视频业务特点及需求,灵活配置审查规则与策略。

 精准内容识别
采用先进的算法和模型,可精准识别各种类型的关键节点。如在足球赛事中,能精准识别开球、精彩射门、进球回放、红黄牌等关键节点,确保精彩瞬间不被遗漏。

 高效自动化处理
通过深度学习等技术,自动识别视频中的关键帧和高光时刻,快速生成视频集锦,减少人工剪辑时间成本,提高内容制作效率。

 质量与风格统一
可依据预设的规则或算法进行剪辑,保证每个集锦的质量和风格保持一致,避免因人工剪辑的差异导致集锦质量参差不齐。

 视觉分析
利用目标检测识别视频中的关键动作(如进球、扣篮)或人物。

 音频分析
通过算法检测观众欢呼或评论员语调变化,定位高潮片段。

 情感识别
结合面部表情和语音情感分析,筛选具有情绪感染力的片段。
 精准识别
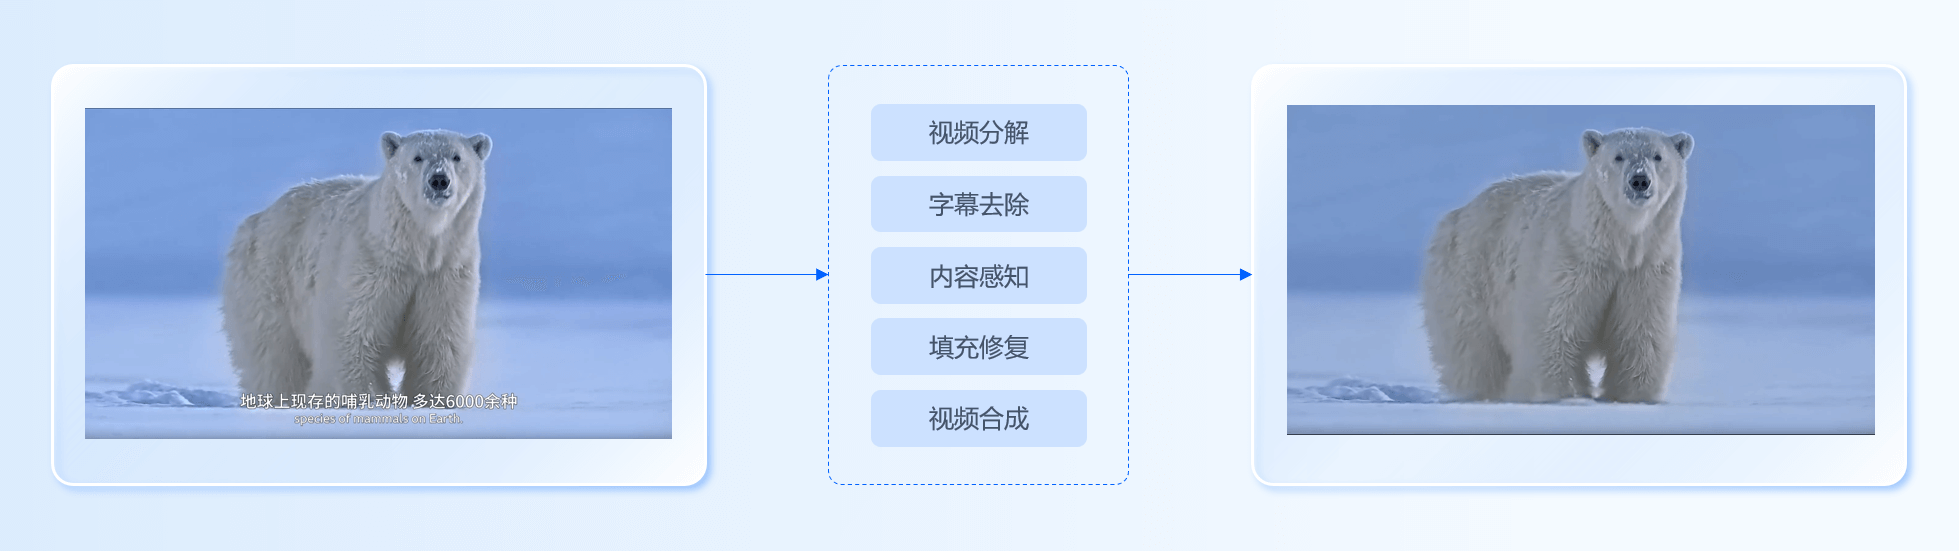
采用深度卷积神经网络等技术,能够自动、精准地定位静态或动态字幕,即使字幕叠加在复杂纹理背景上,也能准确捕捉。
 场景适配性强
不仅能处理普通的静态字幕,还能应对动态花字、半透明文字等复杂场景。
 高效处理
支持批量处理,可同时处理多个视频,能够大大提高工作效率。

 主动检测与追踪
智能识别视频中的显著性目标(如人物、运动物体),并预测其运动轨迹,确保裁剪后主体始终位于画面中心。

 画面平滑
通过感知相似度模型检测镜头切换点,结合上下文信息平滑裁剪坐标,避免画面抖动。

 动态调整策略
利用深度学习模型对视频进行多维度分析,包括场景类型(如体育赛事、访谈)、运动模式(快速移动或静态)以及显著性区域(如人脸、文字),动态调整裁剪策略。

 效果自然
高效识别画面中的动态元素(如球员、球体),确保虚拟广告与真实场景的交互自然。

 多机位同步
确保主机位画面及辅助机位画面广告的一致性,避免出现“穿帮”现象。

 调用灵活
无需对现场任何硬件设备进行任何改动,即可提供灵活、可扩展的广告服务。

 精准语义拆分
基于多模态 AI 算法,融合画面、音频、文字特征,精准识别场景切换、关键事件。

 高效自动化处理
批量处理长视频,秒级完成拆分,大幅降低人工剪辑成本。

 适配多场景需求
兼容不同视频类型(影视、直播、教程、赛事),针对性拆分逻辑。

 自由拓展
可衔接智能封面、字幕生成等功能,形成一站式内容生产链路。

 灵活定制
支持片段标签分类(如 “高光”“知识点”“广告”),方便后续管理。

 自定义拆分
支持自定义拆分规则(如时长、关键词),自动输出多规格短片。

 信息提炼效率高
快速分析视频,几分钟内输出核心摘要。

 关键信息精准度强
准确识别视频核心观点、关键情节或核心数据,不遗漏重要内容也不掺杂冗余信息。

 适配场景广
可满足多场景需求,支持不同类型视频(如课程、会议、新闻、影视)的摘要生成。

 精彩度预测
通过深度学习筛选高光片段,例如体育赛事的进球瞬间或影视剧的高潮情节。

 视觉分析
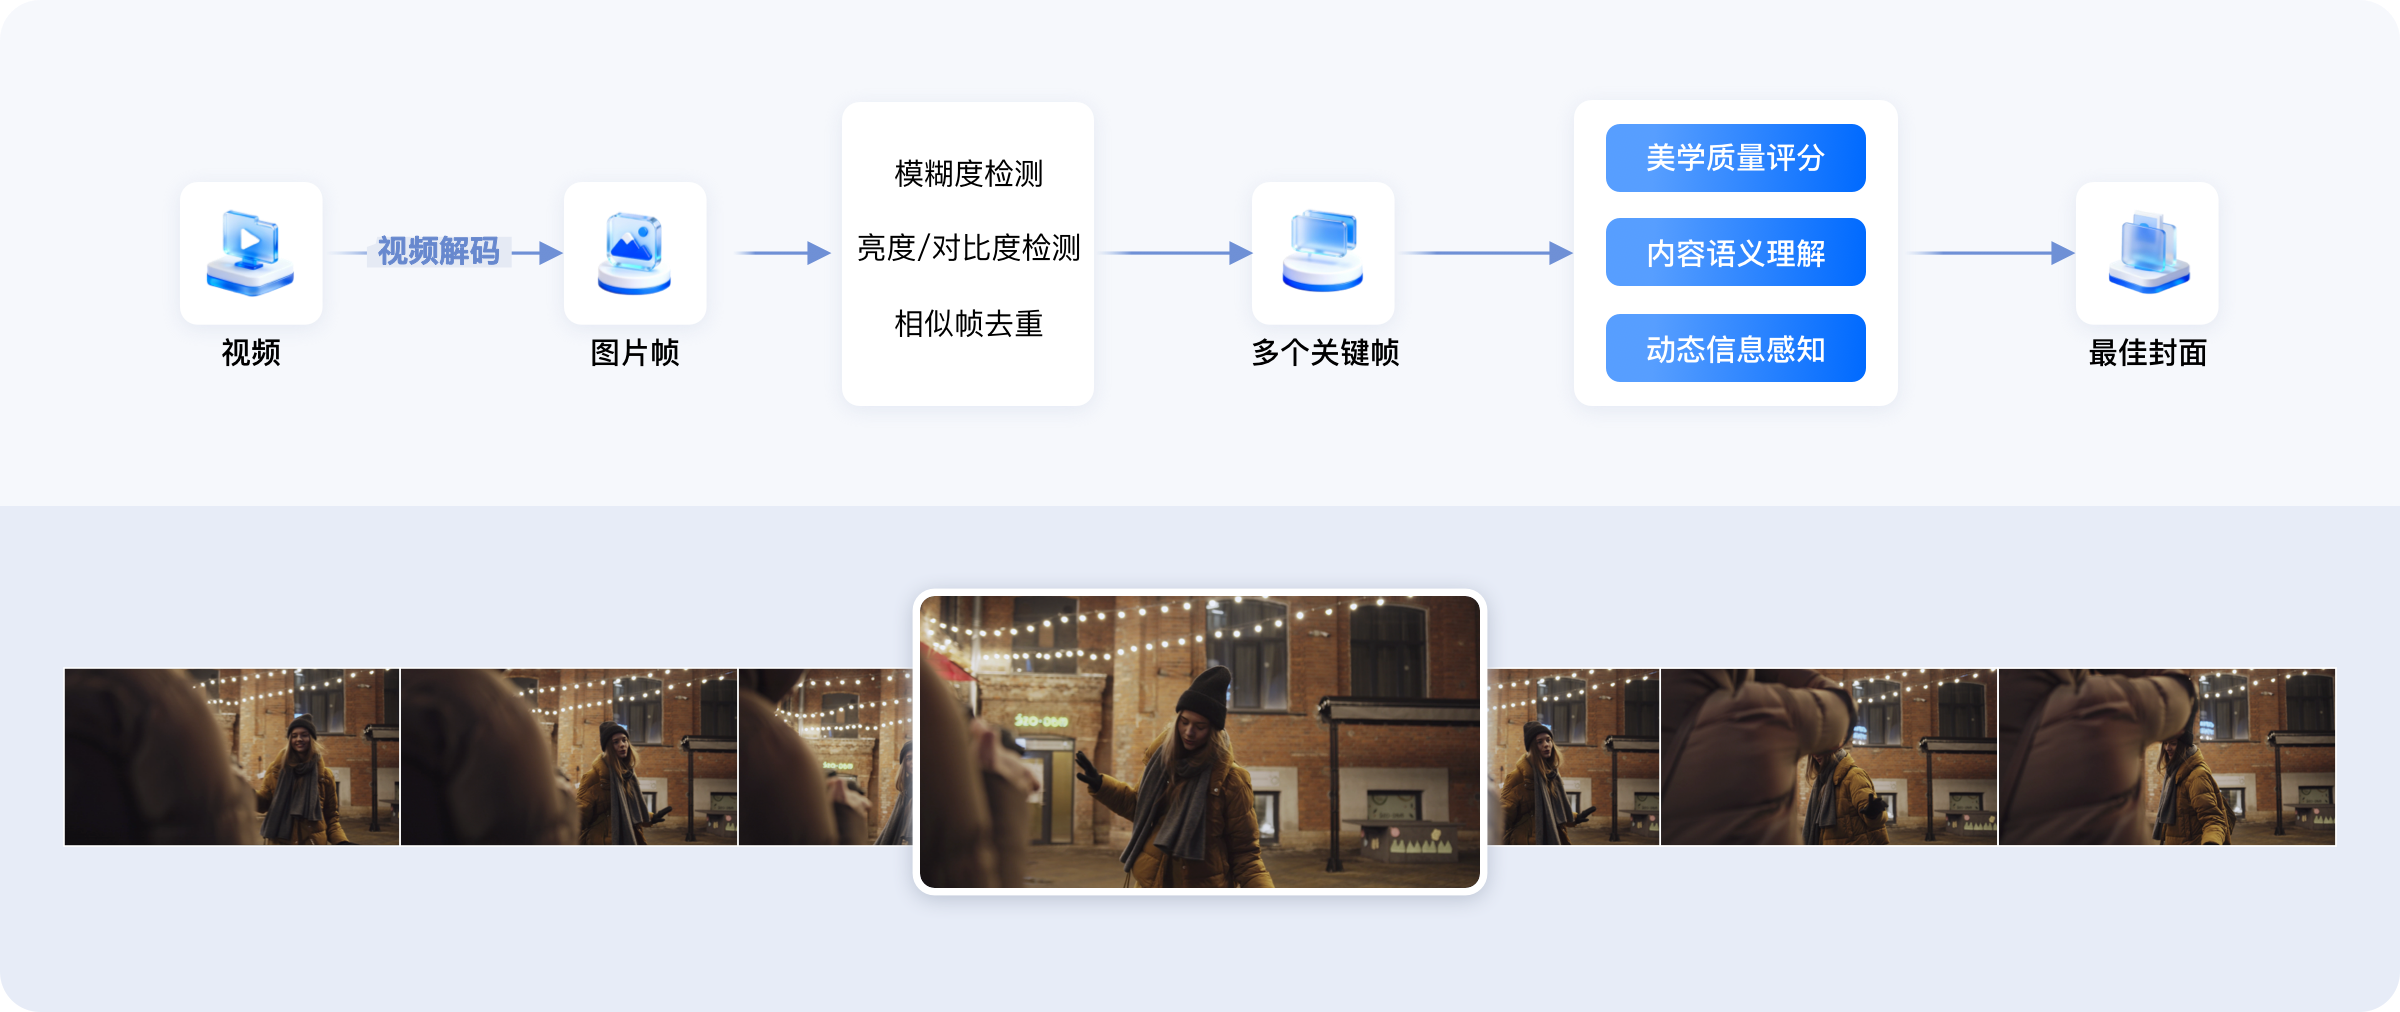
利用目标检测算法识别关键帧中的主体(如人物、场景)和动作,并结合美学评分系统评估画面的构图、光线和清晰度。

 高效自动化
秒级生成高光封面,无需人工筛选。

 精准识别与定位
即使在目标形变、遮挡、光照变化或背景干扰等复杂场景下也能保持稳定跟踪。

 高实时性
可快速处理视频流数据,实时反馈目标的位置和状态信息。

 超高压缩率
相同画质下,Aurora-AV1码率较开源AV1编码方案低30%-50%,可为企业节省大量传输成本。

 超高压缩率
压缩能力突出,对比开源x264编码方案,在相同画质质量的情况下WZ264码率低30%-50%

 专属技术服务
资深codec专家为企业应用场景做专属调优,实现最佳效果和最大化业务收益。

 超高压缩率
相同画质下,Aurora-AV1码率较开源AV1编码方案低30%-50%,可为企业节省大量传输成本。

 低码高清
融合基于深度学习的自适应前处理技术、ROI检测与保护技术,合理分配视频码率,带来高清体验

 迅捷编码速度
编码速度是SVT-AV1的数倍,Aurora-AV1已落地应用在点播、直播、RTC等主要视频应用场景。

 AI+编码
结合宏块级画面检测、智能场景识别,实现基于人眼主观的智能码控算法,选择最优编码参数

 AI+编码
融合AI视频前处理技术、智能码控技术、结合编码内核优化,合理分配视频码率,带来高清体验。

 多场景/全终端支持
提供全平台编码方案,WZ264不仅可以在服务端使用,更能在手机端、PC端进行实时编码

 特殊视频场景适配
面向特殊场景针对性优化,对于胶片颗粒内容、屏幕内容提供高效编码工具,专项优化编码效果。

高可定制的音视频转码模板,支持自定义转码参数,可满足不同场景中多样化的视频处理需求。

支持在输出视频上覆盖图水印,自定义水印位置及大小,增强产品识别度。

 多码率自适应
可将指定的音视频文件流统一打包生成一个自适应码流文件,让播放器可根据终端网络带宽环境。

 支付宝
支付宝在2022年7月份宣布对其生活号进行升级,从以前单一的图文内容,升级为短视频、直播、图文等多种形态,并以信息流的形式聚合在支付宝首页的“生活”频道中。支付宝全球用户超10亿,在庞大的用户基数上,快速、高效构建出一流的视频化能力,是一项巨大挑战。微帧在提供视频编码的基础上,提供了超高清引擎中的画质增强等底层技术,快速实现视频码率与清晰度体验迈入行业超一流水平,并在“春节集五福”“蚂蚁森林”等重大直播活动上给予技术支持和保障。

 倍速转码
适用于10分钟以上的长视频,通过对视频分片并行转码,大幅提升转码速度,转码速度是普通转码的5倍。

 工作流
控制台图形化操作,一分钟快速搭建常见音视频处理流程,媒体上传完成后自动触发转码。

 AI+编码
融合AI预处理、智能码控、ROI检测及保护、智能场景识别、视频质量检测与分析等技术。

 小米电视
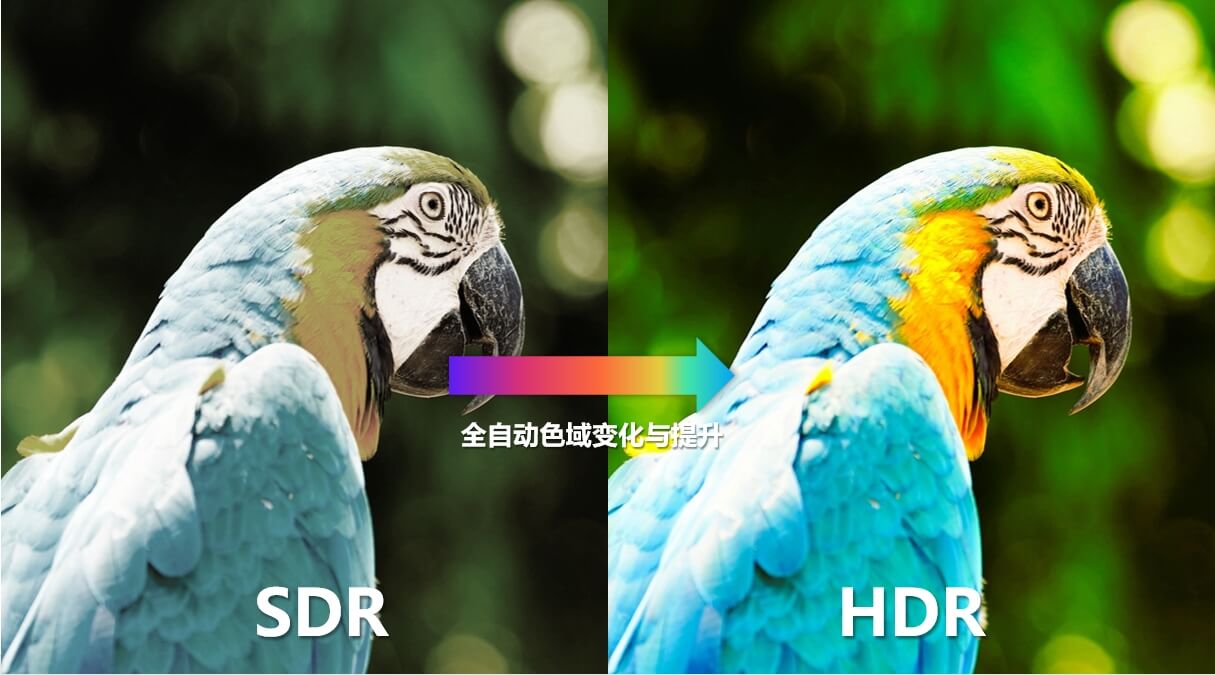
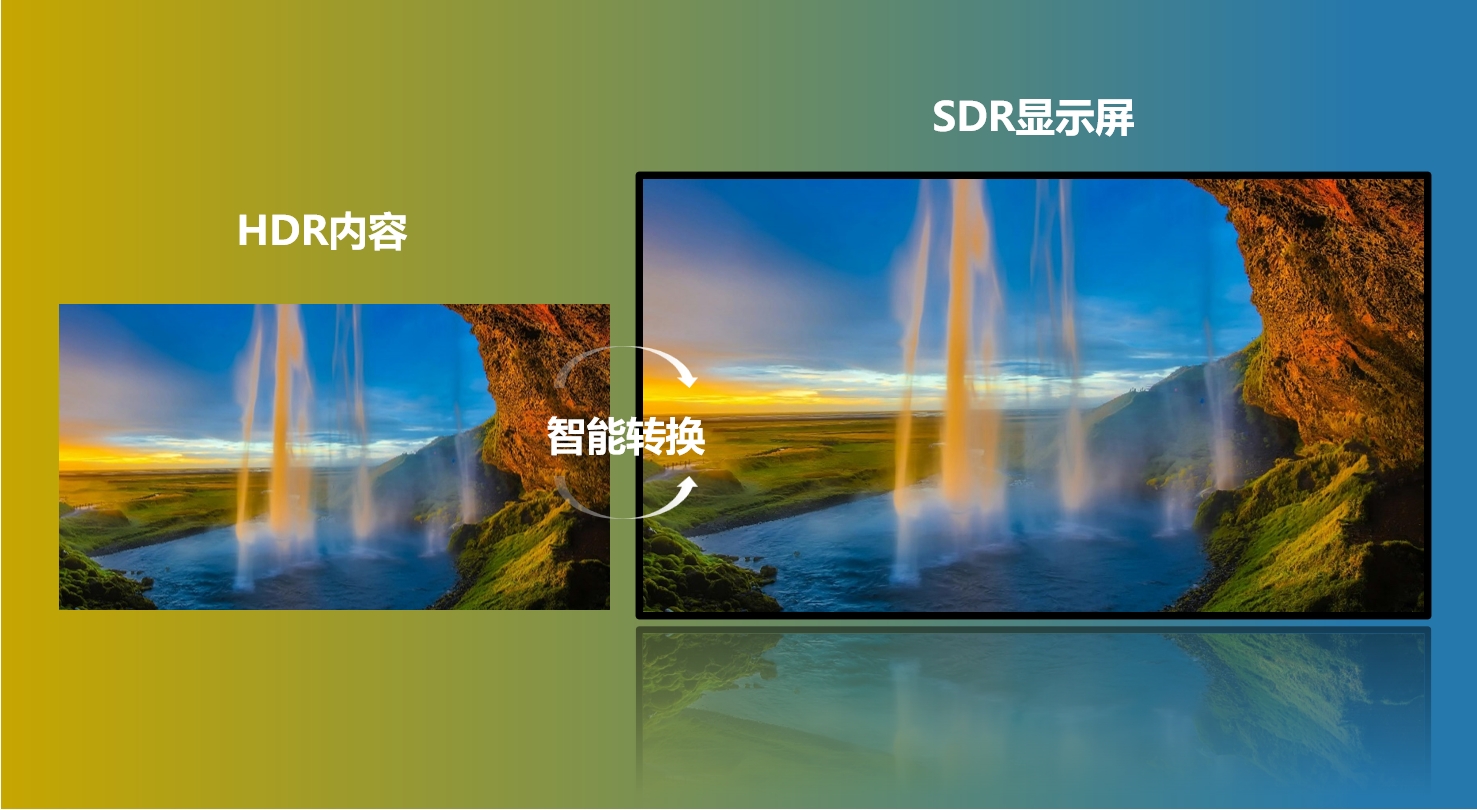
小米电视作为家喻户晓的电视机品牌,一直专注于打造优质内容,不断提升用户体验,平台内的小米影院频道涵盖了海量优质的热播电影及经典老片。微帧利用视频超高清引擎为小米电视赋能,提供HDR色彩渲染能力,将平台的SDR片源,经过算法处理生成帧彩HDR视频,其色彩及亮度都优于原SDR视频,呈现出更极致更真实的光影画面。

 超强技术实力
深耕二十余年,追求极致,连续多年获MSU世界编码器大赛冠军。

 咪咕
咪咕视频是中国移动咪咕公司推出的面向互联网用户推出的高品质综合类视频客户端业务,以视频内容为主,打造新媒体生态体系,内容包括短视频、热播剧集、综艺、电影、体育赛事等。依托基础流能力建立遍布全国的视频直播服务能力,整合 央视及全国各大卫视台直播、回看资源。微帧与咪咕在视频编解码、视频画质增强、智能超分、HDR处理等方向进行了深度探讨,并落地于咪咕旗下的咪咕视频、咪咕视频彩铃等重点业务,为用户带来了全新体验。

 多场景/全终端支持
Linux/Windows/MacOS/Android/iOS全平台支持,全面支持直播、点播、RTC场景。

 接入灵活便捷
私有化部署,针对服务端和各类终端提供多维度的SDK接入方案。客户无需改变原有架构,无缝衔接,接入即用。
专为终端侧优化的神经网络模型,在同等芯片算力下,处理速度提升50%。
独创的低功耗算法,在处理高性能任务时,CPU/GPU占用率与功耗显著低于业界平均水平,有效延长移动设备续航,降低发热。
不仅仅是清晰度提升,更能智能修复细节、抑制噪点、优化动态范围,让色彩更真实、画面更通透。
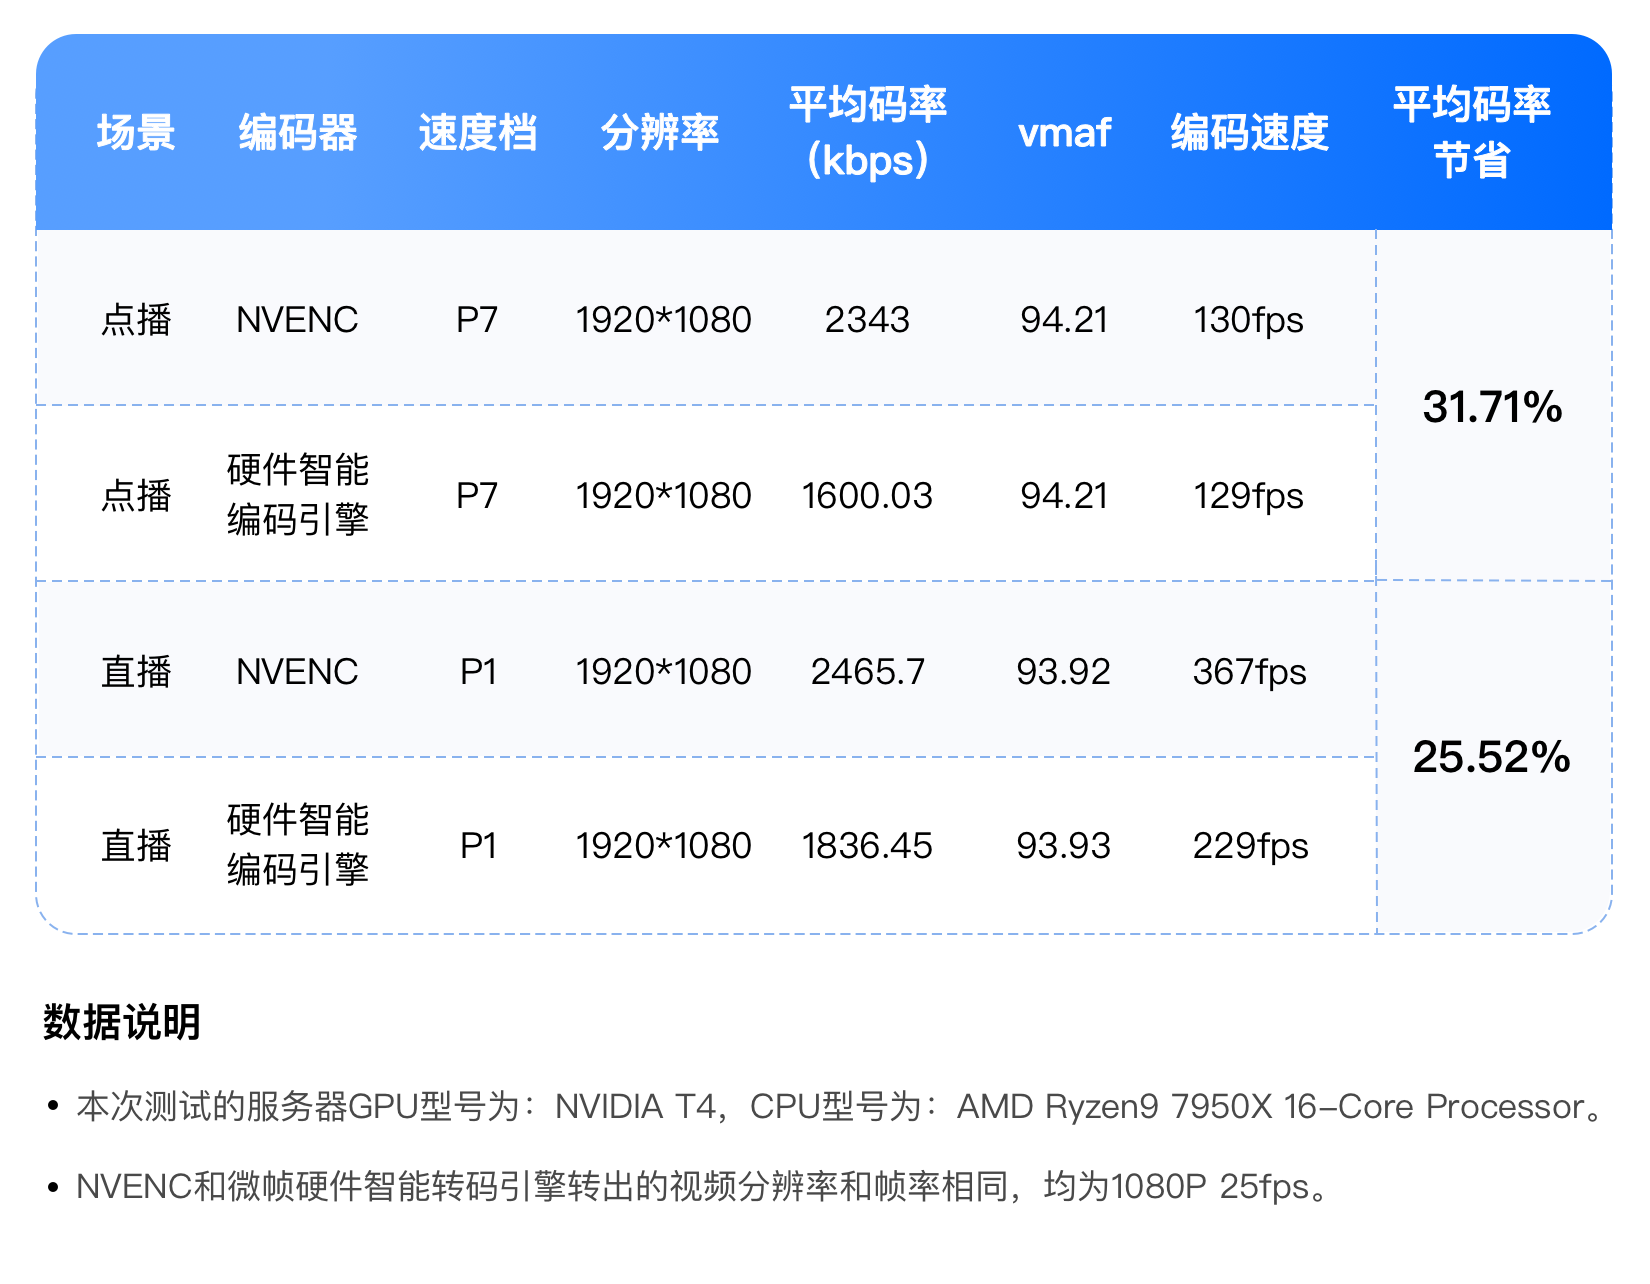
确保GPU硬编速度的前提下,进一步提升压缩率,相同画质下,对比标准GPU硬编转出的视频码率下降20%-30%

 高度兼容
兼容主流网络摄像头、存储设备、视频管理平台。深度适配安防行业主流网络摄像头品牌与标准协议,无需对现有设备进行改造或替换,即可实现快速无缝接入。
高度兼容
兼容主流网络摄像头、存储设备、视频管理平台。深度适配安防行业主流网络摄像头品牌与标准协议,无需对现有设备进行改造或替换,即可实现快速无缝接入。

 多重容灾防护机制
构建了“传输-存储-备份”全链路多重容灾防护体系,确保监控视频数据在各类突发情况下不中断、不丢失。
多重容灾防护机制
构建了“传输-存储-备份”全链路多重容灾防护体系,确保监控视频数据在各类突发情况下不中断、不丢失。

 场景化的内容感知压缩技术
基于微帧自主研发的视频内容感知模型,实时分析监控画面内容,实现场景化的智能压缩策略调度,打破传统固定压缩比的局限。
场景化的内容感知压缩技术
基于微帧自主研发的视频内容感知模型,实时分析监控画面内容,实现场景化的智能压缩策略调度,打破传统固定压缩比的局限。

 画质优于友商
同等画质,码率相较友商低20%,同等码率,画质优于友商,可为企业节省大量传输及存储成本。
画质优于友商
同等画质,码率相较友商低20%,同等码率,画质优于友商,可为企业节省大量传输及存储成本。

 高效稳定运行
业内领先的硬件架构,可根据监控路数需求灵活增减节点。
高效稳定运行
业内领先的硬件架构,可根据监控路数需求灵活增减节点,单机最大并发768路。

 国产化方案
从核心算法到硬件设备实现100%国产化,全面保障技术自主可控与信息安全。
国产化方案
从核心算法到硬件设备实现100%国产化,全面保障技术自主可控与信息安全。

 超高压缩率
突破图片压缩极限,在不影响画质的情况下,将图片大小压缩至原体积的30%~60%。

 多格式适配
支持JPG、PNG、WebP、HEIF、AVIF等格式图片压缩及格式互转压缩,市面上所有图片格式全覆盖。

支持Alpha通道信息拓传,针对透明图片、动态图片,实现近乎无损的压缩效果。

融合智能超分辨率,画质修复,色彩增强等技术,提升图片质量,以达到最佳观感效果。

针对服务端和各类终端提供多维度的SDK接入方案,并支持灵活的API接口,接入即用。

基于人眼主观特性,提供质量分级和质量标签,融合有参考和无参考多种质量评价算法,多维度智能评估图像画质质量。
 Seedance 2.0
字节新一代音视频一体旗舰模型,最长 15 秒、原生 2K 可输出 4K,支持图文音视频多素材参考,多镜头叙事流畅,角色高度统一,适配短剧、商业广告创作。
 Kling-V3
快手可灵推出旗舰视频模型,最长 15 秒、最高 4K,搭载导演模式多镜头叙事,原生音画同步口型精准,大幅强化人物一致性,适配短剧广告创作。
 Wan 2.7
阿里新一代可控视频模型,最长 15 秒、1080P,支持首尾帧约束、多图参考、原生音频唇形同步,可视频续写与指令化二次编辑,画面时序连贯性大幅提升,适配短剧、广告量产创作。
 Vidu Q3
生数科技旗舰音视频一体模型,最高 1080P、最长 16 秒原生声画同步,支持多镜头叙事、多图参考留存角色形象,适配短剧漫剧创作。
 PixVerse-V6
爱诗科技自研 AI 视频模型,最高支持 15秒 1080P 视频,具备物理仿真、多镜头运镜、原生音画同步能力,优化人物细节与动作连贯性,适配短视频、广告、短剧创作。
 Hailuo-H3
Hailuo‑H3 为 MiniMax 开源视频大模型,原生输出 2K‑24fps 成片、自带同步立体声;支持文 / 图生视频、多镜头分镜,低显存显卡可本地部署,适配短视频量产。
Seedance 2.0-fast
Seedance 2.0‑Fast 为提速版本,生成速度快捷,兼顾画质;支持多模态素材输入、自带原生音频,适合快速调试方案、批量产出短视频,免费用户能够使用。
PixVerse-V3.5
爱诗科技迭代短视频模型,5 秒极速生成 5 秒 1080P 短片,新增首尾帧顺滑过渡、多语种唇形同步,二次元画质大幅优化,自带多款特效模板。
PixVerse-V4
爱诗科技有声 AI 视频初代主力模型,5 秒极速生成 1080P 短片,原生一键音效与人声配音,新增视频风格重绘,动态与人物细节大幅优化。
PixVerse-V4.5
爱诗科技迭代视频模型,动态流畅度较 V4 提升 30%,搭载 20 余种运镜操控;支持多画幅、最高 1080P/5 秒、720P 最长 8 秒,人脸连贯稳定,适配短视频、二次元创作。
PixVerse-V5
爱诗科技自研 AI 视频模型,支持最高 1080P、5-8 秒时长,生成极速流畅,可多图融合、精准唇形同步,二次元表现力突出,配短视频、广告创作。
 HappyHorse-1.1
阿里淘天研发 150 亿参数开源视频模型,单流架构一体生成音视频,7 国语言精准唇形同步,8 步极速推理产出 1080P 画面,动态连贯性出众。
Vidu-Q1
生数初代参考生视频模型,主打画面清晰、镜头平稳过渡,率先实现图片锁人设生成 1080P 短视频,角色基础一致性扎实,为后续系列奠定架构,适配早期二次元短视频创作。
Vidu-Q2-Pro-Fast
Q2 Pro 极速轻量化分支,保留旗舰版人物锁定与画质功底,生成速率大幅提升、耗时缩短,性价比更高,适合大批量脚本试稿、短剧片段批量产出。
Vidu-Q2-Pro
Q2专业旗舰版本,角色跨帧一致性拉满,画面细节、影视运镜质感最优,支持图生、视频改写替换,输出成片精致度高,主打广告、漫剧精品内容交付。
Vidu-Q2
迭代升级基础版,大幅优化动态流畅度、画面细节与运镜能力,人物表情动作更自然,支持多参考图输入,720P-1080P 可选,适合日常短视频内容量产。
Vidu-Q3-Mix
生数科技均衡型参考生视频模型,最长 16 秒、1080P 原生音画同步,兼顾画面质感、动态流畅度与角色一致性,适配广告、短剧全域场景。
Vidu-Q3-Turbo
生数科技 Q3 系列极速轻量化视频模型,生成速度更快、调用成本更低,最长 16 秒、支持 1080P 原生音画同步,适配批量短视频创意打样。
Vidu-Q3-Pro
生数科技旗舰专业视频模型,最长 16 秒,最高支持 4K 原生音画同步,人物连贯性、运镜光影拉满,适配精品短剧、商业广告成片。
Seedance-1.5-Pro
字节音画同步一体视频模型,最长 12 秒、支持 1080P,唇形精准适配多语种方言,影视运镜与人物连贯性大幅优化,适配短剧、广告成片创作。
Seedance-1.0-Pro
字节旗舰标准版视频大模型,最高 1080P、最长 12 秒,主打多镜头叙事,人物形象连贯、动作流畅,影视质感出众,适配短剧与广告成片创作。
Sd-1.0-Pro-Lite
字节轻量化 AI 视频模型,主打超高性价比,生成速度快、调用成本低廉,支持 720P/10 秒图文生视频,适合短视频小样批量试稿。
Sd-1.0-Pro-Fast
字节高速视频生成模型,速率较标准版提升三倍、成本大幅下降,支持 1080P 短视频,保留角色连贯与运镜能力,适配批量小样迭代。
Wanx2.6-T2V
阿里通义万相文生视频模型,最高 1080P、最长 15 秒,支持多镜头叙事、原生音画口型同步,人物画面连贯性大幅提升,适配短剧、广告创作。
Wanx2.5-T2V
阿里通义万相文生视频模型,最高 1080P、最长 10 秒,搭载原生音画同步与口型匹配,画面运动更稳定,适配短视频、广告素材创作。
Wanx2.2-T2V
阿里通义万相开源文生视频模型,搭载 MoE 混合专家架构,可生成 5 秒 720P 影片,支持光影镜头精细化调控,人物动作流畅。
Kling-V3-Omni
可灵旗舰专业视频模型,主打跨镜头人物、音色极致一致性,支持自定义分镜、原生音画口型同步,最高 4K/15 秒输出,适配短剧系列成片创作。
Hailuo 01
MiniMax 推出的初代文生视频模型,支持 720p、最长 6 秒短片生成,人物动作流畅,支持文生视频、图生视频,适配短视频创意素材
Kling-V2.5-Turbo
快手可灵高速视频模型,最高支持 1080P、5–10 秒视频,生成速度更快、成本更低,优化动作流畅度与运镜把控,支持文生 / 图生视频,适合批量创意小样。
Hailuo 2.3 Standard
MiniMax 海螺中端视频模型,输出 768p,支持 6/10 秒文生视频、图生视频,优化人物微表情与物理运动,性价比高,适合创意小样批量产出。
Hailuo 2.3 Fast
MiniMax 海螺高速版视频模型,输出 768P,支持 6/10 秒图文生视频,生成更快、成本更低,适合创意小样批量迭代。
Kling-V2
快手可灵第二代视频生成模型,基于 DiT 架构,支持最长 10 秒 1080P 视频,优化人物动作与运镜,搭载 MVL 多模态交互,支持图文生视频、视频元素编辑
Kling-V2.1
快手可灵 2.0 迭代视频模型,分多档位,最高支持 1080P、最长 10 秒,优化人物动作、物理仿真与运镜理解,新增 AI 演员分身功能,支持图文生视频。
Kling-V2.6
快手可灵音视频一体模型,最高支持 10 秒 1080P,新增原生同步音频、口型匹配,优化人物动作与角色一致性,支持文生 / 图生视频。
无需在原生AI模型中直接生成计算量过大的高清画面。仅需驱动大模型生成低清初稿(例如 480P),后续极清解析度和质感还原全部交由像素智绘引擎,将 Token 综合消耗减至 50%。
针对原生低分素材存在物体与文字边缘锯齿重、细节模糊等短板,像素智绘引擎依托低分 + 增强专属链路,实现低分素材无损超分,原生输出高清画面。
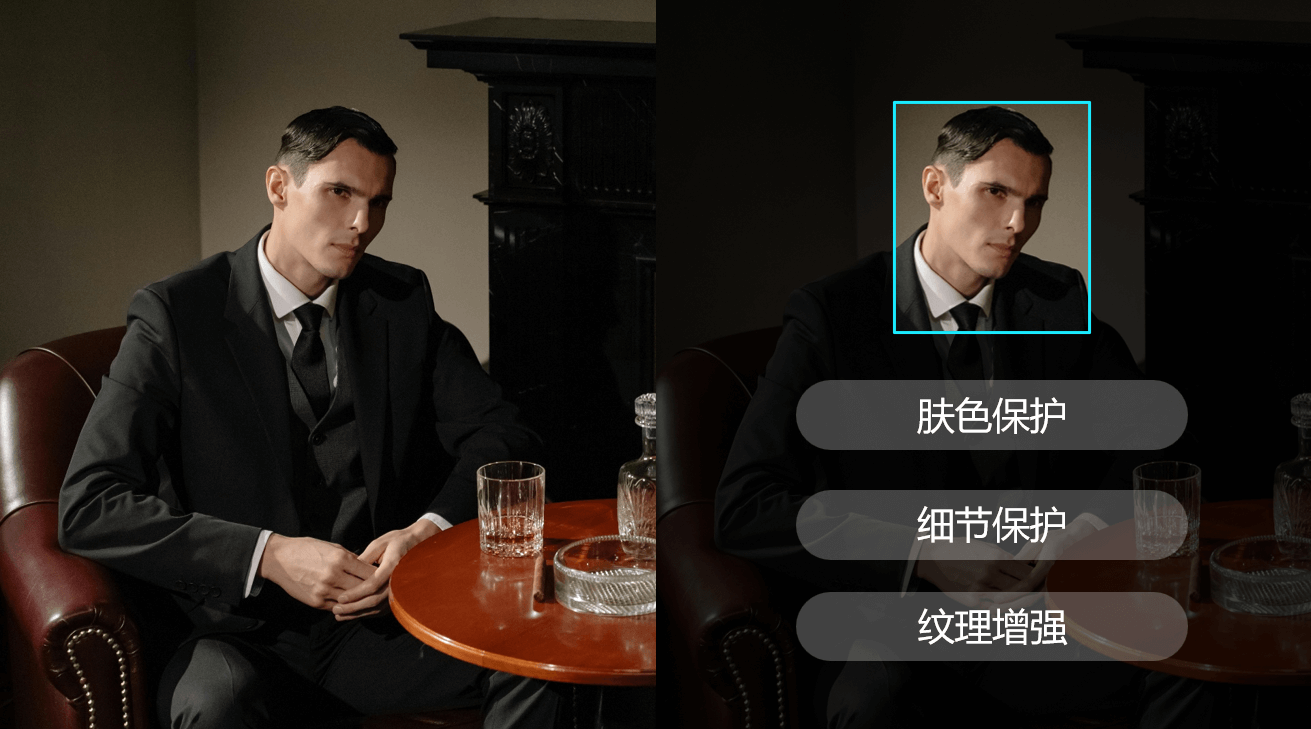
基于 AIGC 图像原生微米结构算法,针对性深度修复失真的皮肤纹理与发丝边缘细节,复刻真人质感。
独有跨帧特征匹配技术,底层统一全帧特征空间。在保证视频动态不失真的前提下,智能抑制画面漂移闪烁,后期人工维护成本直线下降。
业务适配广泛
既能支撑版权保护、侵权追溯,助力原创者维权,也能满足平台视频查重、违规视频快速审核的需求。
大幅降本
替代人工完成视频查重、违规内容筛查、广告监播等大量重复性工作,减少人工成本与时间成本。
超高压缩率
极致压缩算法突破编码能力上限,对比行业同类编码产品,相同画质下视频码率减小30%~50%。
央视频
“央视频”(China Media Group Mobile)是中央广播电视总台基于5G+4K/8K+AI等新技术推出的综合性视听新媒体旗舰平台,也是中国首个国家级5G新媒体平台,于2019年11月20日正式上线,为用户带来了全新视听体验。央视联合微帧在实时直播画质增强方向进行了深度技术探索及合作,如在亚运会、戏曲春晚等大型直播活动中,提供画质增强技术支持,让观众第一时间身临其境感受赛事精彩瞬间。
智能高清
支持H.264、H.265、AV1编码,业内领先的智能高清转码技术,同等视频质量下比普通转码节省40%以上的带宽成本。
卓越H.264编码内核
全球领先的H.264编码方案,世界范围内极少数基于H.264标准的自研编码内核,编码性能卓越
领先的AV1编码内核
全球首家落地应用的AV1软件编码器,技术领先,连续多次获得世界级编码大赛MSU大赛冠军。
视觉无感
人眼完全无法察觉,不改变视频、图片的色彩、清晰度和整体观感,既能藏好标识信息,又不影响用户对原内容的观看体验。
抗攻击能力强
面对视频、图片常见的修改操作都能保持水印稳定,如裁剪、旋转、缩放、添加噪声、格式转换等,水印仍能被准确提取,避免侵权者通过修改内容规避追踪。
安全可靠
具备抗伪造能力,避免不法分子通过技术手段替换原有水印,确保水印与内容的绑定关系不可篡改,保障版权验证、责任认定等场景的有效性。
指纹特性极致可靠
具备绝对唯一性,提取的视频指纹能精准区分不同视频,不会出现特征混淆的情况,可实现对每个视频的唯一标记。
高稳定性
即便视频经过剪辑拼接、格式转换、压缩或旋转等常见修改操作,其核心 DNA 特征也不会改变,能稳定锁定目标视频。
识别准确率高
在识别中保持着零误判记录,对加字幕、调分辨率等变换后的视频,识别准确率也能达到 99% 以上。
保障数据安全
产品存储的仅为视频 DNA 信息,无法通过这些信息反推出完整视频内容,能保障视频原始数据安全。
超高精度识别
精准区分正常与涉黄、暴力、恐怖等违禁画面,即使画面存在模糊、变形、遮挡或使用滤镜特效等干扰因素,也能通过对图像特征的深度挖掘与比对,准确判断其合规性。
实时审查
可在视频播放或上传的瞬间,实时对视频内容进行逐帧、逐秒分析,并迅速给出审查结果。
灵活定制审查
根据视频业务特点及需求,灵活配置审查规则与策略。
精准内容识别
采用先进的算法和模型,可精准识别各种类型的关键节点。如在足球赛事中,能精准识别开球、精彩射门、进球回放、红黄牌等关键节点,确保精彩瞬间不被遗漏。
高效自动化处理
通过深度学习等技术,自动识别视频中的关键帧和高光时刻,快速生成视频集锦,减少人工剪辑时间成本,提高内容制作效率。
质量与风格统一
可依据预设的规则或算法进行剪辑,保证每个集锦的质量和风格保持一致,避免因人工剪辑的差异导致集锦质量参差不齐。
视觉分析
利用目标检测识别视频中的关键动作(如进球、扣篮)或人物。
音频分析
通过算法检测观众欢呼或评论员语调变化,定位高潮片段。
情感识别
结合面部表情和语音情感分析,筛选具有情绪感染力的片段。
精准识别
采用深度卷积神经网络等技术,能够自动、精准地定位静态或动态字幕,即使字幕叠加在复杂纹理背景上,也能准确捕捉。
场景适配性强
不仅能处理普通的静态字幕,还能应对动态花字、半透明文字等复杂场景。
高效处理
支持批量处理,可同时处理多个视频,能够大大提高工作效率。
主动检测与追踪
智能识别视频中的显著性目标(如人物、运动物体),并预测其运动轨迹,确保裁剪后主体始终位于画面中心。
画面平滑
通过感知相似度模型检测镜头切换点,结合上下文信息平滑裁剪坐标,避免画面抖动。
动态调整策略
利用深度学习模型对视频进行多维度分析,包括场景类型(如体育赛事、访谈)、运动模式(快速移动或静态)以及显著性区域(如人脸、文字),动态调整裁剪策略。
效果自然
高效识别画面中的动态元素(如球员、球体),确保虚拟广告与真实场景的交互自然。
多机位同步
确保主机位画面及辅助机位画面广告的一致性,避免出现“穿帮”现象。
调用灵活
无需对现场任何硬件设备进行任何改动,即可提供灵活、可扩展的广告服务。
精准语义拆分
基于多模态 AI 算法,融合画面、音频、文字特征,精准识别场景切换、关键事件。
高效自动化处理
批量处理长视频,秒级完成拆分,大幅降低人工剪辑成本。
适配多场景需求
兼容不同视频类型(影视、直播、教程、赛事),针对性拆分逻辑。
自由拓展
可衔接智能封面、字幕生成等功能,形成一站式内容生产链路。
灵活定制
支持片段标签分类(如 “高光”“知识点”“广告”),方便后续管理。
自定义拆分
支持自定义拆分规则(如时长、关键词),自动输出多规格短片。
信息提炼效率高
快速分析视频,几分钟内输出核心摘要。
关键信息精准度强
准确识别视频核心观点、关键情节或核心数据,不遗漏重要内容也不掺杂冗余信息。
适配场景广
可满足多场景需求,支持不同类型视频(如课程、会议、新闻、影视)的摘要生成。
精彩度预测
通过深度学习筛选高光片段,例如体育赛事的进球瞬间或影视剧的高潮情节。
视觉分析
利用目标检测算法识别关键帧中的主体(如人物、场景)和动作,并结合美学评分系统评估画面的构图、光线和清晰度。
高效自动化
秒级生成高光封面,无需人工筛选。
精准识别与定位
即使在目标形变、遮挡、光照变化或背景干扰等复杂场景下也能保持稳定跟踪。
高实时性
可快速处理视频流数据,实时反馈目标的位置和状态信息。
超高压缩率
相同画质下,Aurora-AV1码率较开源AV1编码方案低30%-50%,可为企业节省大量传输成本。
超高压缩率
压缩能力突出,对比开源x264编码方案,在相同画质质量的情况下WZ264码率低30%-50%
专属技术服务
资深codec专家为企业应用场景做专属调优,实现最佳效果和最大化业务收益。
超高压缩率
相同画质下,Aurora-AV1码率较开源AV1编码方案低30%-50%,可为企业节省大量传输成本。
低码高清
融合基于深度学习的自适应前处理技术、ROI检测与保护技术,合理分配视频码率,带来高清体验
迅捷编码速度
编码速度是SVT-AV1的数倍,Aurora-AV1已落地应用在点播、直播、RTC等主要视频应用场景。
AI+编码
结合宏块级画面检测、智能场景识别,实现基于人眼主观的智能码控算法,选择最优编码参数
AI+编码
融合AI视频前处理技术、智能码控技术、结合编码内核优化,合理分配视频码率,带来高清体验。
多场景/全终端支持
提供全平台编码方案,WZ264不仅可以在服务端使用,更能在手机端、PC端进行实时编码
特殊视频场景适配
面向特殊场景针对性优化,对于胶片颗粒内容、屏幕内容提供高效编码工具,专项优化编码效果。
高可定制的音视频转码模板,支持自定义转码参数,可满足不同场景中多样化的视频处理需求。
支持在输出视频上覆盖图水印,自定义水印位置及大小,增强产品识别度。
多码率自适应
多码率自适应可将指定的音视频文件流统一打包生成一个自适应码流文件,让播放器可根据终端网络带宽环境。
支付宝
支付宝在2022年7月份宣布对其生活号进行升级,从以前单一的图文内容,升级为短视频、直播、图文等多种形态,并以信息流的形式聚合在支付宝首页的“生活”频道中。支付宝全球用户超10亿,在庞大的用户基数上,快速、高效构建出一流的视频化能力,是一项巨大挑战。微帧在提供视频编码的基础上,提供了超高清引擎中的画质增强等底层技术,快速实现视频码率与清晰度体验迈入行业超一流水平,并在“春节集五福”“蚂蚁森林”等重大直播活动上给予技术支持和保障。
倍速转码
适用于10分钟以上的长视频,通过对视频分片并行转码,大幅提升转码速度,转码速度是普通转码的5倍。
工作流
控制台图形化操作,一分钟快速搭建常见音视频处理流程,媒体上传完成后自动触发转码。
AI+编码
融合AI预处理、智能码控、ROI检测及保护、智能场景识别、视频质量检测与分析等技术。
小米电视
小米电视作为家喻户晓的电视机品牌,一直专注于打造优质内容,不断提升用户体验,平台内的小米影院频道涵盖了海量优质的热播电影及经典老片。微帧利用视频超高清引擎为小米电视赋能,提供HDR色彩渲染能力,将平台的SDR片源,经过算法处理生成帧彩HDR视频,其色彩及亮度都优于原SDR视频,呈现出更极致更真实的光影画面。
超强技术实力
深耕二十余年,追求极致,连续多年获MSU世界编码器大赛冠军。
咪咕
咪咕视频是中国移动咪咕公司推出的面向互联网用户推出的高品质综合类视频客户端业务,以视频内容为主,打造新媒体生态体系,内容包括短视频、热播剧集、综艺、电影、体育赛事等。依托基础流能力建立遍布全国的视频直播服务能力,整合 央视及全国各大卫视台直播、回看资源。微帧与咪咕在视频编解码、视频画质增强、智能超分、HDR处理等方向进行了深度探讨,并落地于咪咕旗下的咪咕视频、咪咕视频彩铃等重点业务,为用户带来了全新体验。
多场景/全终端支持
Linux/Windows/MacOS/Android/iOS全平台支持,全面支持直播、点播、RTC场景。
接入灵活便捷
私有化部署,针对服务端和各类终端提供多维度的SDK接入方案。客户无需改变原有架构,无缝衔接,接入即用。
专为终端侧优化的神经网络模型,在同等芯片算力下,处理速度提升50%。
独创的低功耗算法,在处理高性能任务时,CPU/GPU占用率与功耗显著低于业界平均水平,有效延长移动设备续航,降低发热。
不仅仅是清晰度提升,更能智能修复细节、抑制噪点、优化动态范围,让色彩更真实、画面更通透。
确保GPU硬编速度的前提下,进一步提升压缩率,相同画质下,对比标准GPU硬编转出的视频码率下降20%-30%
高度兼容
兼容主流网络摄像头、存储设备、视频管理平台。深度适配安防行业主流网络摄像头品牌与标准协议,无需对现有设备进行改造或替换,即可实现快速无缝接入。
高度兼容
兼容主流网络摄像头、存储设备、视频管理平台。深度适配安防行业主流网络摄像头品牌与标准协议,无需对现有设备进行改造或替换,即可实现快速无缝接入。
多重容灾防护机制
构建了“传输-存储-备份”全链路多重容灾防护体系,确保监控视频数据在各类突发情况下不中断、不丢失。
多重容灾防护机制
构建了“传输-存储-备份”全链路多重容灾防护体系,确保监控视频数据在各类突发情况下不中断、不丢失。
场景化的内容感知压缩技术
基于微帧自主研发的视频内容感知模型,实时分析监控画面内容,实现场景化的智能压缩策略调度,打破传统固定压缩比的局限。
场景化的内容感知压缩技术
基于微帧自主研发的视频内容感知模型,实时分析监控画面内容,实现场景化的智能压缩策略调度,打破传统固定压缩比的局限。
画质优于友商
同等画质,码率相较友商低20%,同等码率,画质优于友商,可为企业节省大量传输及存储成本。
画质优于友商
同等画质,码率相较友商低20%,同等码率,画质优于友商,可为企业节省大量传输及存储成本。
高效稳定运行
业内领先的硬件架构,可根据监控路数需求灵活增减节点。
高效稳定运行
业内领先的硬件架构,可根据监控路数需求灵活增减节点,单机最大并发768路。
国产化方案
从核心算法到硬件设备实现100%国产化,全面保障技术自主可控与信息安全。
国产化方案
从核心算法到硬件设备实现100%国产化,全面保障技术自主可控与信息安全。
超高压缩率
突破图片压缩极限,在不影响画质的情况下,将图片大小压缩至原体积的30%~60%。
多格式适配
支持JPG、PNG、WebP、HEIF、AVIF等格式图片压缩及格式互转压缩,市面上所有图片格式全覆盖。
支持Alpha通道信息拓传,针对透明图片、动态图片,实现近乎无损的压缩效果。
融合智能超分辨率,画质修复,色彩增强等技术,提升图片质量,以达到最佳观感效果。
针对服务端和各类终端提供多维度的SDK接入方案,并支持灵活的API接口,接入即用。
基于人眼主观特性,提供质量分级和质量标签,融合有参考和无参考多种质量评价算法,多维度智能评估图像画质质量。
Seedance 2.0
字节新一代音视频一体旗舰模型,最长 15 秒、原生 2K 可输出 4K,支持图文音视频多素材参考,多镜头叙事流畅,角色高度统一,适配短剧、商业广告创作。
Kling-V3
快手可灵推出旗舰视频模型,最长 15 秒、最高 4K,搭载导演模式多镜头叙事,原生音画同步口型精准,大幅强化人物一致性,适配短剧广告创作。
Wan 2.7
阿里新一代可控视频模型,最长 15 秒、1080P,支持首尾帧约束、多图参考、原生音频唇形同步,可视频续写与指令化二次编辑,画面时序连贯性大幅提升,适配短剧、广告量产创作。
Vidu Q3
生数科技旗舰音视频一体模型,最高 1080P、最长 16 秒原生声画同步,支持多镜头叙事、多图参考留存角色形象,适配短剧漫剧创作。
PixVerse-V6
爱诗科技自研 AI 视频模型,最高支持 15秒 1080P 视频,具备物理仿真、多镜头运镜、原生音画同步能力,优化人物细节与动作连贯性,适配短视频、广告、短剧创作。
Hailuo-H3
Hailuo‑H3 为 MiniMax 开源视频大模型,原生输出 2K‑24fps 成片、自带同步立体声;支持文 / 图生视频、多镜头分镜,低显存显卡可本地部署,适配短视频量产。
Seedance 2.0-fast
Seedance 2.0‑Fast 为提速版本,生成速度快捷,兼顾画质;支持多模态素材输入、自带原生音频,适合快速调试方案、批量产出短视频,免费用户能够使用。
PixVerse-V3.5
爱诗科技迭代短视频模型,5 秒极速生成 5 秒 1080P 短片,新增首尾帧顺滑过渡、多语种唇形同步,二次元画质大幅优化,自带多款特效模板。
PixVerse-V4
爱诗科技有声 AI 视频初代主力模型,5 秒极速生成 1080P 短片,原生一键音效与人声配音,新增视频风格重绘,动态与人物细节大幅优化。
PixVerse-V4.5
爱诗科技迭代视频模型,动态流畅度较 V4 提升 30%,搭载 20 余种运镜操控;支持多画幅、最高 1080P/5 秒、720P 最长 8 秒,人脸连贯稳定,适配短视频、二次元创作。
PixVerse-V5
爱诗科技自研 AI 视频模型,支持最高 1080P、5-8 秒时长,生成极速流畅,可多图融合、精准唇形同步,二次元表现力突出,配短视频、广告创作。
HappyHorse-1.1
阿里淘天研发 150 亿参数开源视频模型,单流架构一体生成音视频,7 国语言精准唇形同步,8 步极速推理产出 1080P 画面,动态连贯性出众。
Vidu-Q1
生数初代参考生视频模型,主打画面清晰、镜头平稳过渡,率先实现图片锁人设生成 1080P 短视频,角色基础一致性扎实,为后续系列奠定架构,适配早期二次元短视频创作。
Vidu-Q2-Pro-Fast
Q2 Pro 极速轻量化分支,保留旗舰版人物锁定与画质功底,生成速率大幅提升、耗时缩短,性价比更高,适合大批量脚本试稿、短剧片段批量产出。
Vidu-Q2-Pro
Q2专业旗舰版本,角色跨帧一致性拉满,画面细节、影视运镜质感最优,支持图生、视频改写替换,输出成片精致度高,主打广告、漫剧精品内容交付。
Vidu-Q2
迭代升级基础版,大幅优化动态流畅度、画面细节与运镜能力,人物表情动作更自然,支持多参考图输入,720P-1080P 可选,适合日常短视频内容量产。
Vidu-Q3-Mix
生数科技均衡型参考生视频模型,最长 16 秒、1080P 原生音画同步,兼顾画面质感、动态流畅度与角色一致性,适配广告、短剧全域场景。
Vidu-Q3-Turbo
生数科技 Q3 系列极速轻量化视频模型,生成速度更快、调用成本更低,最长 16 秒、支持 1080P 原生音画同步,适配批量短视频创意打样。
Vidu-Q3-Pro
生数科技旗舰专业视频模型,最长 16 秒,最高支持 4K 原生音画同步,人物连贯性、运镜光影拉满,适配精品短剧、商业广告成片。
Seedance-1.5-Pro
字节音画同步一体视频模型,最长 12 秒、支持 1080P,唇形精准适配多语种方言,影视运镜与人物连贯性大幅优化,适配短剧、广告成片创作。
Seedance-1.0-Pro
字节旗舰标准版视频大模型,最高 1080P、最长 12 秒,主打多镜头叙事,人物形象连贯、动作流畅,影视质感出众,适配短剧与广告成片创作。
Sd-1.0-Pro-Lite
字节轻量化 AI 视频模型,主打超高性价比,生成速度快、调用成本低廉,支持 720P/10 秒图文生视频,适合短视频小样批量试稿。
Sd-1.0-Pro-Fast
字节高速视频生成模型,速率较标准版提升三倍、成本大幅下降,支持 1080P 短视频,保留角色连贯与运镜能力,适配批量小样迭代。
Wanx2.6-T2V
阿里通义万相文生视频模型,最高 1080P、最长 15 秒,支持多镜头叙事、原生音画口型同步,人物画面连贯性大幅提升,适配短剧、广告创作。
Wanx2.5-T2V
阿里通义万相文生视频模型,最高 1080P、最长 10 秒,搭载原生音画同步与口型匹配,画面运动更稳定,适配短视频、广告素材创作。
Wanx2.2-T2V
阿里通义万相开源文生视频模型,搭载 MoE 混合专家架构,可生成 5 秒 720P 影片,支持光影镜头精细化调控,人物动作流畅。
Kling-V3-Omni
可灵旗舰专业视频模型,主打跨镜头人物、音色极致一致性,支持自定义分镜、原生音画口型同步,最高 4K/15 秒输出,适配短剧系列成片创作。
Hailuo 01
MiniMax 推出的初代文生视频模型,支持 720p、最长 6 秒短片生成,人物动作流畅,支持文生视频、图生视频,适配短视频创意素材
Kling-V2.5-Turbo
快手可灵高速视频模型,最高支持 1080P、5–10 秒视频,生成速度更快、成本更低,优化动作流畅度与运镜把控,支持文生 / 图生视频,适合批量创意小样。
Hailuo 2.3 Standard
MiniMax 海螺中端视频模型,输出 768p,支持 6/10 秒文生视频、图生视频,优化人物微表情与物理运动,性价比高,适合创意小样批量产出。
Hailuo 2.3 Fast
MiniMax 海螺高速版视频模型,输出 768P,支持 6/10 秒图文生视频,生成更快、成本更低,适合创意小样批量迭代。
Kling-V2
快手可灵第二代视频生成模型,基于 DiT 架构,支持最长 10 秒 1080P 视频,优化人物动作与运镜,搭载 MVL 多模态交互,支持图文生视频、视频元素编辑
Kling-V2.1
快手可灵 2.0 迭代视频模型,分多档位,最高支持 1080P、最长 10 秒,优化人物动作、物理仿真与运镜理解,新增 AI 演员分身功能,支持图文生视频。
Kling-V2.6
快手可灵音视频一体模型,最高支持 10 秒 1080P,新增原生同步音频、口型匹配,优化人物动作与角色一致性,支持文生 / 图生视频。
集各项高效能力于一身的产品
AI+编码,实现极致压缩
视频智能编码引擎
突破编码极限,实现超高压缩效率
AI超高清处理引擎
智能画质增强,焕新超高清观感
AI画质评价
无限接近人眼视觉,全自动画质评分
极速编码
倍数优于开源编码器
CAE内容感知编码
适配内容场景的动态编码优化
FilmGrain编码优化
编码过程中保留胶片颗粒质感
10bit HDR 265编码
尽享HDR丰富色彩
RTC屏幕内容编码
屏显画质与速度双优
Per-title编码
同码率画质跃升
AI预处理
智能降噪去模糊省码率
智能码控
智能适配网络,动态码率分配
全链路H.265方案
H.265多端编码解码全覆盖
图片智能压缩引擎
倍数压缩,不减画质
应用场景
微帧AI大模型平台是什么?与直接使用各模型厂商的API有什么区别?
微帧AI大模型平台是一个统一接入主流文本、图片和视频模型的API平台。你不需要分别维护不同厂商的账户、API Key、计费系统和接口,通过一个API Key和一个计费账户即可调用平台支持的模型。

短视频增强
利用AI超分、色彩增强等技术,快速将用户上传的模糊、低分辨率、色彩暗淡的视频,处理成更清晰、色彩更鲜艳的高质量视频,改善观看效果,增加用户停留时间。
微帧AI大模型平台支持哪些AI模型和模型厂商?
微帧AI大模型平台提供来自字节、MiniMax、生数、阿里、快手等厂商的热门对话、图片和视频模型。你可以前往模型库查看模型当前的可用状态、能力和价格。
短剧增强
短剧制作周期短、成本受限,可能在某些场景下(如使用手机拍摄、特效渲染)画质不统一。超高清处理可用于统一并提升全片画质,进行降噪、锐化和色彩风格化处理,提升短剧的整体品质和竞争力。
切换AI模型时,需要重新开发接口吗?
我们为平台支持的模型提供相对统一的API调用体验。通常只需修改模型参数,而不需要为每个厂商重新开发一套接口。不同模型的输入参数和能力可能存在差异,因此切换生产流量前仍需查看对应模型文档。
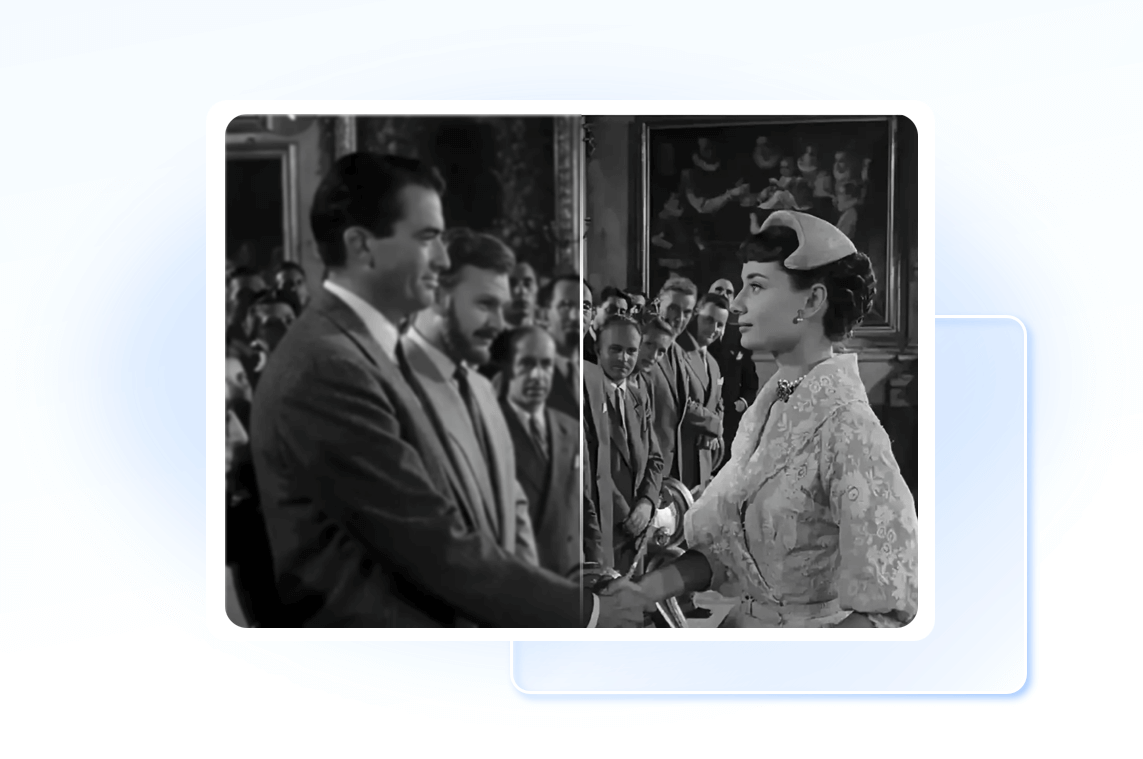
经典老片增强
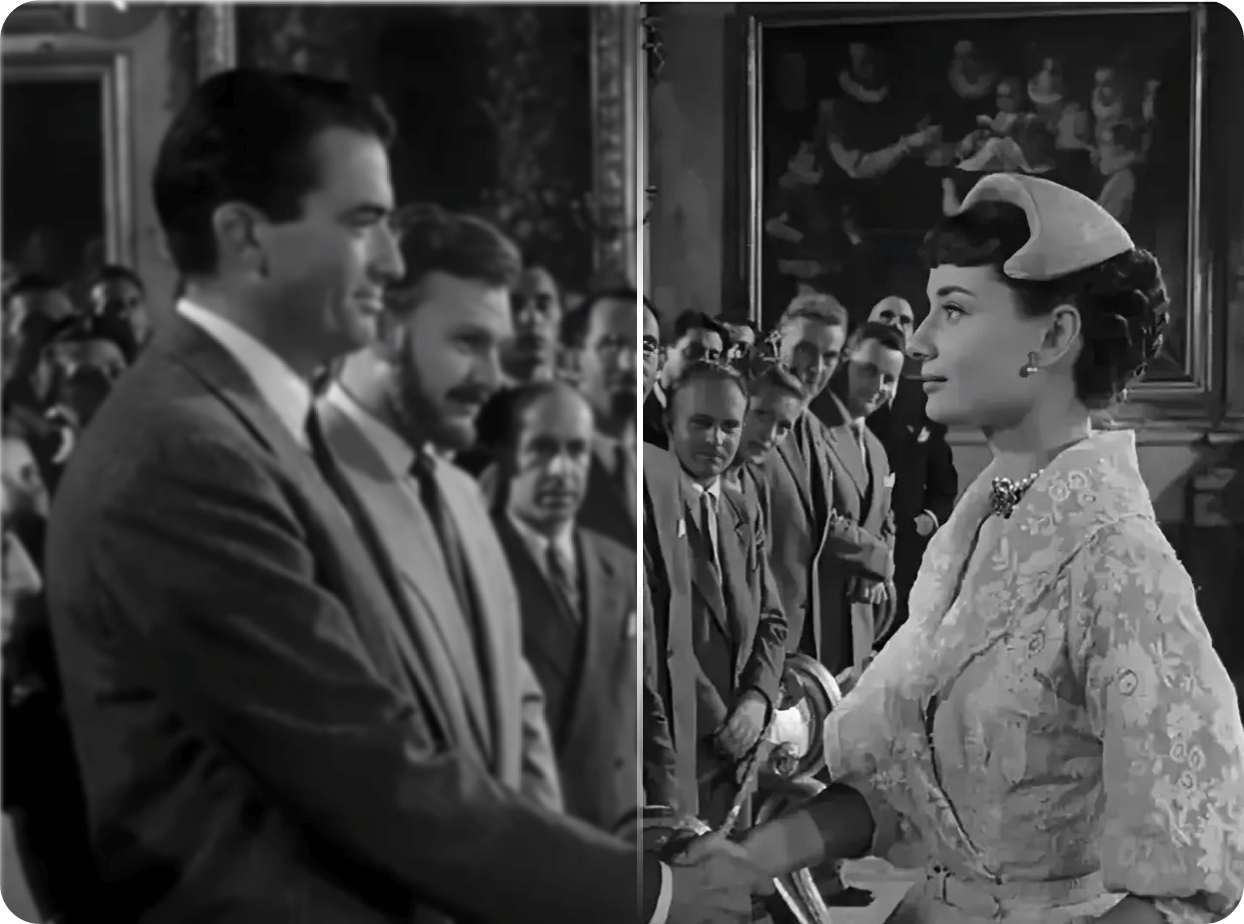
通过去噪、去划痕、去抖动、色彩校正、分辨率提升(至4K/8K) 等一系列流程,让老旧影视剧焕发新生。
费用如何计算?
采用按量付费模式,但具体计费单位取决于模型。对话模型通常按输入和输出Token计费;图片模型可能按张、按次请求或图片Token计费;视频模型可能按次、时长、分辨率或视频Token计费。
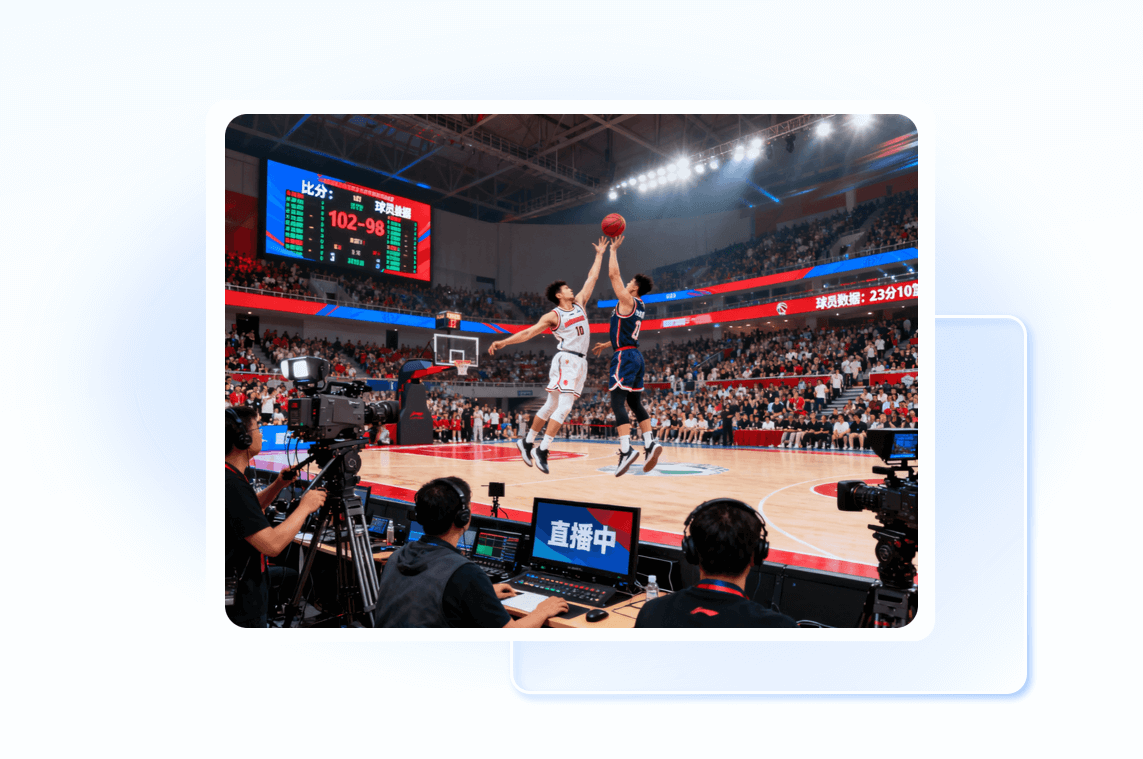
体育赛事直播
通过实时超分、HDR处理、插帧等技术,将接收到的1080p信号实时增强为4K HDR信号,为观众带来更真实的色彩,高清晰度和高帧率画面完美展现高速运动的瞬间,不遗漏任何精彩细节。
Intinor
Intinor 是瑞典领先的高端视频贡献与分发解决方案提供商。在追求极致视频画质的过程中,客户面临着如何在有限的卫星或移动网络带宽下,保持直播视频的稳定性与专业级观感。 微帧为 Intinor 提供了基于 WZ265 (HEVC) 的云端直播转码引擎。依托微帧领先的感知编码技术,Intinor 在生产流程中实现了极高的压缩效率。Intinor 成功将流媒体传输码率降低至 2.5 Mbps。对比此前 5 Mbps 的方案,不仅带宽需求减半,更呈现出比以往更加清晰、稳定且细节精美的画质效果。
ABS-CBN
ABS-CBN是菲律宾最大的radio broadcaster、娱乐电视制作公司、节目联合发行提供商和媒体集团,是东南亚历史最悠久的电视广播公司之一,也是菲律宾第一个进行彩色电视广播的公司。微帧为 ABS-CBN 旗下全球流媒体平台 iWant 提供 AuroraCloud 云服务及云端视频压缩服务;依托微帧AI驱动的编码算法(可降低 40% 以上带宽消耗)、多云集成能力及灵活适配的专属解决方案,iWant 实现了带宽与运营成本的显著降低、用户观看体验的优化及可扩展云基础设施的构建,成功应对亚太地区带宽有限等市场挑战。
NBC Sports Engine Play
NBC Sports Engine Play 是由 NBC Sports Next 推出的一款深耕青少年及业余体育赛事的流媒体平台。作为该领域的“YouTube + Netflix”,它致力于为家长、教练和运动员打造一个集记录、直播与观赛于一体的一站式生态。微帧Visionular作为核心技术合作伙伴,为该平台提供了从底层视频处理到上层应用交互的全栈支持。通过微帧的高效视频AI服务方案,平台实现了稳定高清的赛事直播、便捷的点播回放以及无限的云端存储。此外,结合实时计分板与AI精彩集锦剪辑功能,微帧助力 NBC SportsEngine Play 将非职业赛事的呈现效果提升专业级水准,确保每一个精彩瞬间都能被精准定格与广泛传播。
小米电视
小米电视作为家喻户晓的电视机品牌,一直专注于打造优质内容,不断提升用户体验。小米电视平台内的儿童频道以动画内容为主,微帧为其提供了云端智能转码服务,动画内容与摄像头拍摄的画面不同,无自然噪声,无特别复杂的画面,微帧的云端智能编码算法针对此内容进行了定向调优,在确保画质无损的前提下大幅降低码率,为小米电视节省了巨大带宽成本。

网易有道词典
网易有道是中国领先的智能学习公司,致力于提供100%以用户为导向的学习产品和服务,核心产品网易有道词典是家喻户晓的国民级翻译和语言学习app,截止到2023年6月,月活用户达5000万。有道词典自制的短视频栏目具备学习与娱乐两大属性,用户在碎片化时间也能愉快的学习知识,微帧为其提供了云端智能转码服务,观看流畅度的提升及内容画质的优化,大幅提升了产品用户粘性。

PP视频
PP视频又名PPTV网络电视,是全球华人领先的、规模较大、拥有较大影响力的视频媒体,全面聚合和精编影视、体育、娱乐、资讯等各种热点视频内容。基于大众对PGC内容超清的画质要求,微帧为PP视频提供了云端视频智能编码压缩服务,保障用户在各种网络环境下都能流畅观影,助力PP视频向用户提供最新、及时、高清的网络电视媒体服务。

kumu
kumu是菲律宾本土的一家社交媒体平台,于2018年推出,并于2020年高居苹果App Store和谷歌Play免费应用下载排行榜的榜首,成为了菲律宾本土收入最高的社交平台。为了在菲律宾这样的弱网地区,保障平台视频画质及用户体验,kumu融合了微帧强大的编码内核,并结合了云端媒体处理模式,接入微帧在东南亚区域建设的转码节点,完美衔接kumu原有基础云架构,使得视频码率降低40%以上,极大提升观看流畅度。

Stage.in
Stage.in是一家印度语言内容平台(OTT),也是全球首个方言OTT内容平台,提供基于不同印度方言的诗歌、电影、励志内容等各种娱乐形式,提供的内容包括喜剧、民间艺术、诗歌、故事讲述和励志内容等。微帧根据印度地区OTT相应的技术规范要求,为Stage.in提供了云端极致压缩编码服务,保障了当地用户在不同网络环境下也能流畅享用高清视频。

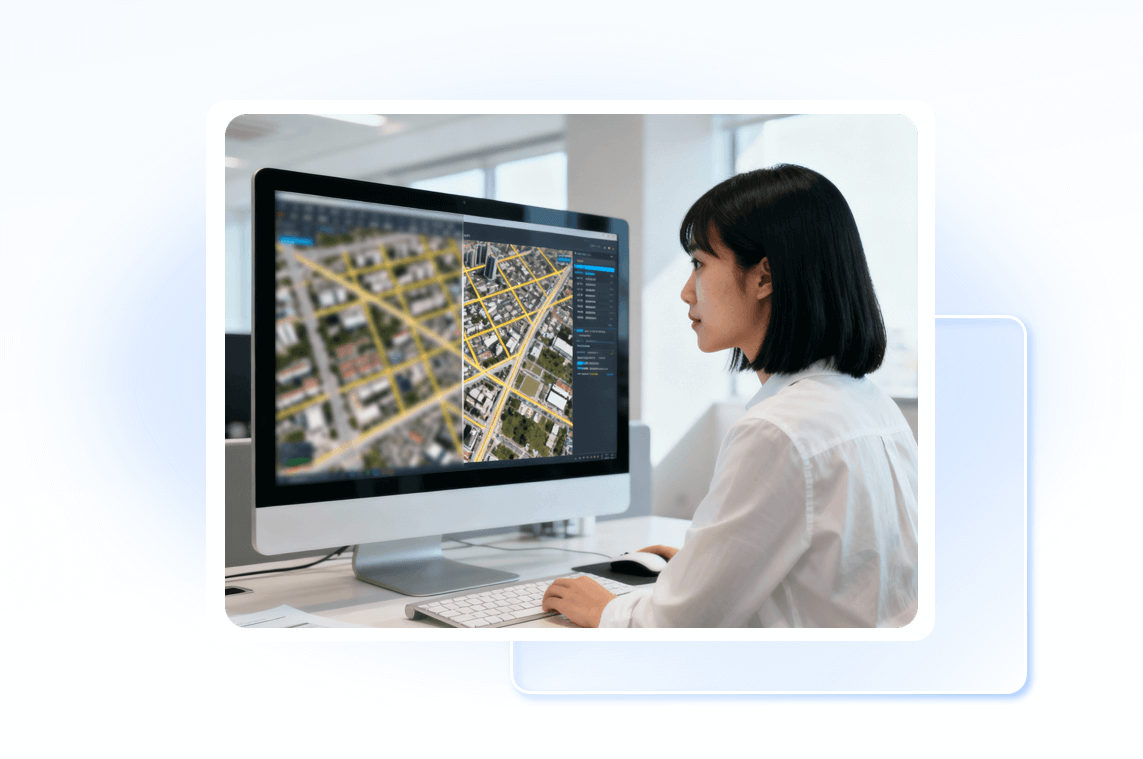
卫星图像增强
将低空间分辨率的卫星图像通过超分技术提升其分辨率,使得图像中的地物特征(如建筑物、道路、车辆、植被)更加清晰可辨。
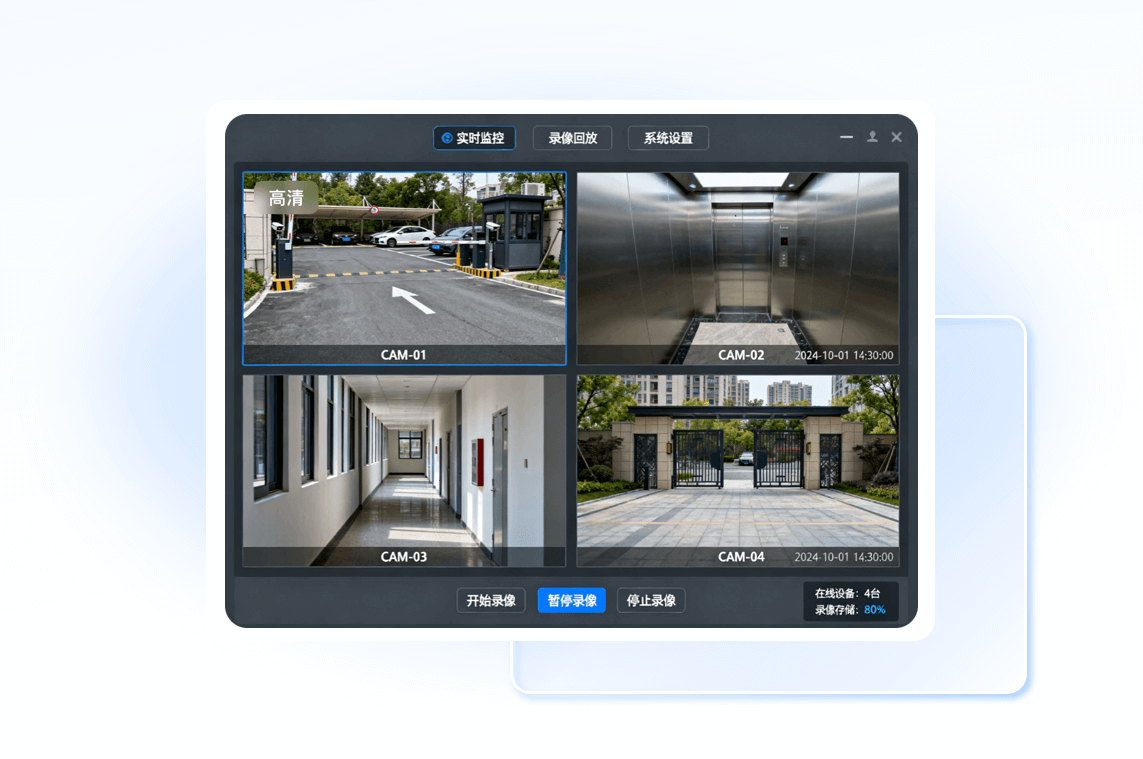
监控画面增强
对低光照、高噪点、模糊不清的监控录像进行去噪、超分、去模糊、去雾等处理,提取出关键信息。
图片处理的数据存储在哪里?
图片处理的数据可灵活存储到您指定路径下,支持多云存储。
为什么输出格式没有 GIF?
微帧图片压缩不建议使用 GIF 格式,因为其体积大,效果不好。通常对于动图我们建议使用HEIF、AVIF 等更先进的格式来代替 GIF。
图片压缩方案支持怎样的接入方式?
私有化部署方案以及API调用。
HEIF解码生态怎么样?
硬件支持情况苹果A9处理器(iphone 6s)以上,高通骁龙855以上:软件支持情况iOS11及以上
图片质量如何评估?
和视频类似, 一方面看客观指标,传统看psnr、ssim,互联网比较认可vmaf;配合主观评估。
微帧还可以提供哪些图片的压缩?
支持格式:JPG、BMP、GIF、PNG、WEBP; 支持输出:JFEG、WEBP、HEIF、AVIF。
短视频
自适应短视频丰富的场景化内容,助力多家头部短视频、内容平台构建智能转码服务,大幅降低视频带宽CDN成本;帮助短视频客户,解决码率与画质的最佳体验平衡问题。
短视频
自适应短视频丰富的场景化内容,助力多家头部短视频、内容平台构建智能转码服务,大幅降低视频带宽CDN成本;帮助短视频客户,解决码率与画质的最佳体验平衡问题。

短视频
自适应短视频丰富的场景化内容,助力多家头部短视频、内容平台构建智能转码服务,大幅降低视频带宽CDN成本;帮助短视频客户,解决码率与画质的最佳体验平衡问题。

直播
满足各类直播场景(秀场、游戏、电商、事件赛事等)对实时性的要求,支持全平台的编码方案,可在推流端或服务端进行智能编码,实现码流更小、质量更好,提升直播流畅性体验且大幅降低传输带宽成本。
直播
满足各类直播场景(秀场、游戏、电商、事件赛事等)对实时性的要求,支持全平台的编码方案,可在推流端或服务端进行智能编码,实现码流更小、质量更好,提升直播流畅性体验且大幅降低传输带宽成本。

直播
满足各类直播场景(秀场、游戏、电商、事件赛事等)对实时性的要求,支持全平台的编码方案,可在推流端或服务端进行智能编码,实现码流更小、质量更好,提升直播流畅性体验且大幅降低传输带宽成本。

影视长视频
针对影视类长视频的高清画质诉求,在编码方面以接近“肉眼无失真”的效果进行深度压缩,可同时结合HDR、超分辨率、修复增强等各项技术,为终端用户提供更好的观看体验。
影视长视频
针对影视类长视频的高清画质诉求,在编码方面以接近“肉眼无失真”的效果进行深度压缩,可同时结合HDR、超分辨率、修复增强等各项技术,为终端用户提供更好的观看体验。

影视长视频
针对影视类长视频的高清画质诉求,在编码方面以接近“肉眼无失真”的效果进行深度压缩,可同时结合HDR、超分辨率、修复增强等各项技术,为终端用户提供更好的观看体验。

在线教育
针对教育类典型场景,在师生互动、课件内容(屏幕共享)等方面定向优化,体验更好的同时降低近50%视频码率,助力多家头部在线教育平台降本增效。
在线教育
针对教育类典型场景,在师生互动、课件内容(屏幕共享)等方面定向优化,体验更好的同时降低近50%视频码率,助力多家头部在线教育平台降本增效。

在线教育
针对教育类典型场景,在师生互动、课件内容(屏幕共享)等方面定向优化,体验更好的同时降低近50%视频码率,助力多家头部在线教育平台降本增效。
视频会议
基于视频会议的多终端及软硬件设备,满足RTC超低延时的编码速度门槛,同时大幅压缩码率和降低资源开销,为视频会议提供更流畅的互动体验。
视频会议
基于视频会议的多终端及软硬件设备,满足RTC超低延时的编码速度门槛,同时大幅压缩码率和降低资源开销,为视频会议提供更流畅的互动体验。

视频会议
基于视频会议的多终端及软硬件设备,满足RTC超低延时的编码速度门槛,同时大幅压缩码率和降低资源开销,为视频会议提供更流畅的互动体验。
广电OTT
满足广电、OTT的相应技术规范要求,提供超高清(4K/8K)内容生产、高清智能转码、HDR、视频修复等各类服务,技术稳定效果突出。
广电OTT
满足广电、OTT的相应技术规范要求,提供超高清(4K/8K)内容生产、高清智能转码、HDR、视频修复等各类服务,技术稳定效果突出。

广电OTT
满足广电、OTT的相应技术规范要求,提供超高清(4K/8K)内容生产、高清智能转码、HDR、视频修复等各类服务,技术稳定效果突出。

智能监控
针对商超、交通、社区、安防等各类场景化监控视频,进行离线/实时处理压缩,大幅降低视频的存储成本,解决上云、传输、大屏观看等瓶颈问题,提升业务效率。
智能监控
针对商超、交通、社区、安防等各类场景化监控视频,进行离线/实时处理压缩,大幅降低视频的存储成本,解决上云、传输、大屏观看等瓶颈问题,提升业务效率。

智能监控
针对商超、交通、社区、安防等各类场景化监控视频,进行离线/实时处理压缩,大幅降低视频的存储成本,解决上云、传输、大屏观看等瓶颈问题,提升业务效率。
云桌面 /云游戏
以强悍的编码性能满足云流化场景(云游戏、云桌面等)的超低延时极高门槛,在知名云桌面平台上大规模应用达到端到端时延30MS(1080P/4K分辨率),突破软编性能极限同时发挥压缩和画质优势,解决场景痛点。
云桌面/云游戏
以强悍的编码性能满足云流化场景(云游戏、云桌面等)的超低延时极高门槛,在知名云桌面平台上大规模应用达到端到端时延30MS(1080P/4K分辨率),突破软编性能极限同时发挥压缩和画质优势,解决场景痛点。

云桌面 /云游戏
以强悍的编码性能满足云流化场景(云游戏、云桌面等)的超低延时极高门槛,在知名云桌面平台上大规模应用达到端到端时延30MS(1080P/4K分辨率),突破软编性能极限同时发挥压缩和画质优势,解决场景痛点。

微帧监控视频压缩设备支持哪些摄像头接入协议?
微帧视频智能压缩系统全面适配安防主流协议,支持海康SDK、大华SDK、宇视SDK、国标GB28181、ONVIF、RTSP等主流视频接入协议,无需替换原有摄像头、NVR、监控平台,可实现老旧安防系统无缝对接改造。
微帧边缘压缩终端单台支持多少路监控并发?
WZ Live 2101 边缘终端单机最大支持16 路 1080P、或 4 路 4K 监控视频实时智能压缩,支持多路不同分辨率摄像头混合并发运行,适配工地、油气站、边防等点位分散的小型边缘场景。
微帧监控视频压缩设备支持哪些摄像头接入协议?
微帧视频智能压缩系统全面适配安防主流协议,支持海康SDK、大华SDK、宇视SDK、国标GB28181、ONVIF、RTSP等主流视频接入协议,无需替换原有摄像头、NVR、监控平台,可实现老旧安防系统无缝对接改造。
微帧边缘压缩盒子和压缩服务器有什么区别?该怎么选型?
WZ Live 2101 为边缘点位小型终端,体积小巧可就近部署在摄像头旁、工地机房、海上基站,解决前端窄带传输带宽不足问题;WZ Live 5101 是机房集中压缩服务器,支持 768 路大规模园区、公安连片监控。点位零散、带宽有限选 2101,上千路集中机房项目选中心服务器。
压缩后的监控视频支持哪些输出协议,可对接原有公安平台吗?
压缩视频支持GB28181、ONVIF、RTSP、RTMP多协议输出,完全适配公安、高速、地铁、医院等国标安防管理平台,压缩后视频流可直接上原有平台,无需二次适配开发。
支持野外无稳定机房环境长期 7×24 小时运行吗?
设备采用全金属散热工业机身,宽温硬件设计,适应油田、工地、边防、海上牧场高低温野外环境,支持全年不间断稳定压缩,内置硬件看门狗,异常自动重启恢复任务,适配无人值守边缘点位。
安防监控视频压缩最高能节省多少存储带宽?
依托微帧自研内容感知智能编码技术,真实场景可实现5-30倍码率压缩,极大降低硬盘存储容量、服务器带宽及CDN传输成本。
能做到多少倍压缩?压缩后影响车牌、人脸识别吗?
可实现5-30倍码率压缩;设备遵循人眼 + 机器视觉双无损标准,分辨率、帧率、编码完全不变,人脸、车牌、人形识别精度不受影响,取证画面清晰可用。
监控视频压缩是固定压缩比还是智能动态压缩?
区别于传统固定压缩比设备,微帧采用场景化内容感知压缩,可实时识别监控画面静止、车流、人流、夜间、雨雪等场景,动态调度压缩策略,静止画面高压缩、动态画面保细节,兼顾极致瘦身与画质效果。
边缘终端是固定压缩比例,还是自动适配画面动静?
搭载微帧自研场景内容感知模型,自动区分静止画面、车流、人员、雨雪夜间场景;静态画面大幅降低码率,动态人车区域保留细节,区别于传统固定压缩盒子,带宽节省效果更优。
视频压缩后会模糊吗?影响人脸识别、车牌识别吗?
不会。设备实现双无损压缩标准:人眼视觉无损 + 机器视觉无损。严格遵循四不变原则:分辨率、帧率、编码格式、视频时长完全不变,压缩后人眼看不出差异,同时不干扰公安AI抓拍、车牌识别、人形检测等智能算法精度。
同等画质下,WZ Live 2101 对比市面边缘压缩设备码率优势有多大?
同等主观清晰度下,码率比行业同类边缘终端低 20%;偏远油气、边防窄带线路,可大幅降低跨区域回传卡顿、丢包问题,长期节省存储与专线带宽成本。
同等画质下,微帧安防压缩设备相比友商有什么优势?
同等主观画质下,微帧码率比行业友商低20%以上;同等码率条件下,画面细节、动态流畅度更优,大幅降低政企长期存储与带宽运营成本,是高性价比安防视频轻量化方案。
WZ Live 2101 兼容海康、大华普通监控摄像头吗,需要改原有监控系统吗?
全面兼容海康、大华、宇视主流 IPC,支持 GB28181、ONVIF、RTSP 标准接入协议;旁路串接部署,无需更换摄像头、NVR、原有平台,存量工地、油田项目改造零施工改动,当天上线。
微帧视频压缩服务器单机支持多少路监控并发?
微帧WZ Live系列压缩服务器硬件性能强劲,单机最大支持768路视频并发压缩,支持多路不同分辨率、不同协议监控视频混合运行,支持集群节点灵活扩容,适配大规模公安、高速连片监控场景。
海上牧场、远洋船舶 4G/5G 窄带网络,部署 2101 能解决传输卡顿吗?
专为窄带边缘场景优化,AI 动态降码机制大幅降低上行流量,4G 弱网、海上波动网络下减少卡顿、丢帧,偏远油气井、边防哨所、海上养殖基地均可稳定回传监控画面。
中心侧服务器和边缘压缩终端有什么区别?
WZ Live 5101/5201为中心侧压缩服务器,部署机房,负责大规模集中视频转码压缩;边缘压缩终端部署前端点位,实现极致视频瘦身、边缘实时降码率,中心+边缘双层架构,适配大小各类安防项目。
部署视频压缩系统需要改造原有监控设备吗?
无需改造、无需替换原有摄像头、存储、平台设备。设备高度兼容海康、大华、宇视等主流安防品牌,即插即用无缝接入,项目改造周期短、施工成本低、风险极低。
哪些边缘场景适合部署 WZ Live 2101 压缩终端?
适配石油油田、建筑工地、边防海防、海上牧场、远洋船舶、野外光伏电站、乡镇加油站等点位分散、上行带宽有限、无大型机房的边缘监控场景,单点 16 路以内小型项目首选。
8K、4K超高清监控视频可以智能压缩吗?
支持D1至8K全分辨率视频接入压缩,支持多分辨率混合并发运行,输出分辨率自适应跟随源视频,超高清监控也能实现极致无损瘦身。
微帧监控压缩设备是国产化方案吗?
全套方案100%纯国产化,从核心编码算法、AI内容感知模型到硬件服务器终端,全部自主可控,无海外开源依赖,满足政企、公安、交通、国企等国产化替代与信息安全合规要求。
政企私有化项目可以本地化部署吗?
支持完全私有化内网部署,所有监控视频数据不出企业内网,杜绝数据外泄风险,适配公安涉密、交通政务、医院隐私等合规严苛场景。
应用场景
全球公司的共同选择
作为全球领先的生活服务电子商务平台,美团拥有餐饮、外卖、酒店旅游等海量业务场景。每天有数亿张涉及美食、实景、商品展示的图片在平台上传与传播,图片质量直接影响用户的消费决策,而海量的存储与带宽开销也对技术基础设施提出了严峻挑战。微帧为美团提供了图片智能压缩引擎。该引擎融合了AI智能感知技术,能够针对不同业务场景进行自适应压缩。在确保人眼主观画质几乎无损的前提下,将图片体积大幅降低。
支付宝多垂类短视频在不同来源与类型间存在画质差异,影响用户体验与品牌形象,亟需建立统一的质量标准并持续优化。利用微帧AI画质评价系统,通过对视频进行精细化分类与增强、效果评估与标准建立、持续监控与预警、优化推荐排序。最终达到高质量视频占比提升,画质差异显著缩小;用户停留时长、播放完成率、互动率等指标正向增长。
SnapChat 是全球领先的图片与视频社交平台,月活跃用户超过 9.32 亿。平台在全球范围内需处理海量用户生成的视频内容,不同来源与质量差异显著,存在块效应、闪烁、细节丢失等问题,影响最终编码与用户观看体验。通过微帧AI画质评价系统,对视频进行源质量甄别、画质问题检测、自适应增强等,最终显著减少块效应与闪烁等质量问题,同时节省了运维与算力成本,用户观看体验与平台满意度大幅提升。

天猫精灵哇哦闺蜜机于8月初发布,微帧科技作为深耕视频领域的技术领航者,联合天猫精灵打造了定制化AI智能增强技术方案,即精灵原画AI视效增强。不同于传统视频应用平台所采用的增强技术,该方案核心在于直接部署于设备终端,依托设备内置的GPU与NPU的强大计算性能,实现对视觉内容的实时增强处理。值得一提的是,这项创新性的突破,真正达成了算力高效利用与能耗合理控制的完美平衡,它不仅显著提升了视觉内容的品质,同时确保了设备的续航能力不受影响,维护了用户在日常使用中的流畅体验。

小红书APP是年轻人的生活方式平台,通过图文及视频的展现方式分享美妆、穿搭、宠物、美食、旅游等内容,引领用户的生活方式。截止到2023年3月,其平台月活用户已破2亿。视频化是小红书一个重要的发展方向,通过使用WZ265编码器,保持视频的高清晰度降低视频码率,提升用户体验,为小红书视频业务提供高效支持。同时,基于小红书的美妆内容特色,微帧进行定向优化,利用Pseudo HDR将色彩还原至肉眼可辨的色彩保真效果,极大提升了用户体验。
《最右》是一款运行于移动平台的网络信息类软件,也是一个看搞笑短视频的社区。随着社区内图片内容的占比越来越大,图片压缩与质量优化迫在眉睫,最右率先看到了HEIF格式图片的压缩优势,于是在与微帧合作视频智能编码引擎之后,再次合作图片编码压缩引擎,在带宽成本节省上和用户体验优化上获得了巨大收益。

虎牙直播是以游戏直播为主的弹幕式互动直播平台,累计注册用户超2亿,提供热门游戏直播、电竞赛事直播与游戏赛事直播,手游直播等。游戏直播往往要求高画质、高分辨率和高帧率,以英雄联盟S11赛季为例,每场次的观看次数达到数千万,在传输成本和效率上,给平台带来不小的挑战。WZ265智能编码引擎助力虎牙直播业务,在服务端进行智能编码,在保证高画质的前提下,节省码率,提升直播流畅性及清晰度。

支付宝在2022年7月份宣布对其生活号进行升级,从以前单一的图文内容,升级为短视频、直播、图文等多种形态,并以信息流的形式聚合在支付宝首页的“生活”频道中。支付宝全球用户超10亿,在庞大的用户基数上,快速、高效构建出一流的视频化能力,是一项巨大挑战。微帧提供视频编码/画质增强等底层技术,快速实现视频码率与清晰度体验迈入行业超一流水平,并在“春节集五福”“蚂蚁森林”等重大直播活动上给予技术支持和保障。

H3Cloud云桌面解决方案是为用户量身打造的稳定、易用的云桌面解决方案,将虚拟化的桌面组件转移在云数据中心进行统一管理、集中控制,更安全、便捷。云桌面场景的落地,对于编码器是个不小的挑战。不仅要求保持画面高质量,更要达到1080p甚至4k的超低延时实时编码。微帧与新华三对云桌面编码深度打磨,保持画质更优的同时降低码率,大大提升传输效率,保障用户体验,提升产品竞争力。

汽车之家是国内顶级的汽车资讯平台,为用户提供新闻、行情、评测等内容,是车友的必备 APP。微帧提供全场景的264服务端编码方案,为汽车之家的点播、直播业务提供支持。在“2021汽车之家818全球汽车夜”上,微帧提供边缘编码方案,有效保障了整个晚会的直播质量,与汽车之家一起带来超高清画质+观感流畅的极致体验。

ShareChat是印度本土的社交媒体平台,是印度第一个允许用户分享视频、音频、图片的社交分享应用,目前每月有超过 1.6 亿的活跃用户。但印度网络环境较差,用户在播放短视频时经常出现加载慢、卡顿等问题,微帧提供了WZ264、WZ265智能编码器,并与ShareChat一起探索符合当地特色的视频处理架构,从码流、质量、播放体验等方面构建一套全新的技术方案,助力视频业务。另外微帧还为ShareChat提供了WZ265解码器,解码速度及稳定性都有了很大提升。

好未来是一家中国领先的教育科技企业,以科技驱动、人才亲密、品质领先为发展的核心目标。 自创立以来,一直致力于促进科技互联网与教育融合,为孩子创造更美好的学习体验。微帧为好未来提供高效的264编码器,在不损伤画质的情况下降低码率,应用于大班课、小班课、1v1及点播场景,大大提升了用户体验,减少卡顿,视频观看更流畅。

奇虎360是中国领先的互联网安全软件与互联网服务公司、致力于通过提供高品质的免费安全服务,为中国互联网用户解决上网时遇到的各种安全问题。旗下不仅有360安全卫士、360手机卫士等产品,更有快剪辑、快资讯、花椒直播等现象级产品。微帧科技为360提供智能编码方案,赋能旗下多条业务线,为360视频业务保驾护航。

Snapchat是一款图片分享软件应用,设有地图 (Map)、聊天 (Chat)、相机 (Camera)、故事 (Stories) 和聚光灯短视频(Spotlight)共5个一级Tab,提供好友位置动态共享、聊天、相机和AR滤镜体验、购物、内容浏览与分享等多种功能。目前Snapchat全球月活用户 (MAU) 超过7.5亿,且在全球20多个国家和地区覆盖超过75%的13- 34岁用户,在Gen Z和千禧一代中有着很强的影响力。微帧为其提供了性能更强、速度更快、压缩效率更高的服务端WZ265智能编码引擎,并针对不同种类视频进行主观调优,显著提升了用户体验及用户粘性。

Cloudinary是一家图像与视频管理解决方案的云服务商,连续4年入选福布斯全球云服务100榜单,在全球拥有NBC、Under Armour、Nintendo、Levi's等8000+客户和10万+应用开发者。Cloudinary看到了AVIF带来的图像技术发展趋势,与微帧建立合作伙伴关系,率先在平台上支持AVIF能力,显著提升图片的压缩效率,降低图片加载时间,为用户提供无与伦比的图像观看体验。

Verizon是美国最大的有线通信和语音通信提供商,拥有1.4亿条接入线,在美国住宅用户市场上的占有率已达成三分之一。基于高分辨率、高帧率、低带宽占用的三大诉求,Verizon选择了微帧的Aurora-AV1智能编码引擎来支持他们的RTC平台,以超高画质提升屏幕内容共享体验,同事节省了近半的CDN带宽成本。

hudl是美国一款为教练和运动员提供比赛录像的分析工具,并有针对性地优化团队合作。用户可以通过hudl客户端回看视频,捕捉、编辑比赛或训练瞬间,并通过工具标注需要分析的地方,以供教学使用。为了更精准分析比赛录像,hudl对于清晰度有着极大要求,因此hudl选择了微帧的WZ264及WZ265智能编码引擎,相对于原有HW/SW H.264/HEVC编码解决方案具有更优越的视觉质量,与其他竞争解决方案相比,在更低比特率下的VMAF主观分数提高了8-10分。

作为全球实时互动API平台开创者,声网以其高可用、高质量的技术实力和解决方案服务了全球众多企业。面对不同区域、不同场景的客户视频清晰度与体验诉求,声网率先在RTC领域尝试H.265、AV1等新编码标准。微帧为声网提供部分底层编解码能力,进行有效技术补充,在RTC场景下码率更低、画质更好,软件提升用户体验降低传输成本。
好未来是一家中国领先的教育科技企业,以科技驱动、人才亲密、品质领先为发展的核心目标。 自创立以来,一直致力于促进科技互联网与教育融合,为孩子创造更美好的学习体验。微帧为好未来提供高效的264编码器,在不损伤画质的情况下降低码率,应用于大班课、小班课、1v1及点播场景,大大提升了用户体验,减少卡顿,视频观看更流畅。
汽车之家是国内顶级的汽车资讯平台,为用户提供新闻、行情、评测等内容,是车友的必备 APP。微帧提供全场景的264服务端编码方案,为汽车之家的点播、直播业务提供支持。在“2021汽车之家818全球汽车夜”上,微帧提供边缘编码方案,有效保障了整个晚会的直播质量,与汽车之家一起带来超高清画质+观感流畅的极致体验。
H3Cloud云桌面解决方案是为用户量身打造的稳定、易用的云桌面解决方案,将虚拟化的桌面组件转移在云数据中心进行统一管理、集中控制,更安全、便捷。云桌面场景的落地,对于编码器是个不小的挑战。不仅要求保持画面高质量,更要达到1080p甚至4k的超低延时实时编码。微帧与新华三对云桌面编码深度打磨,保持画质更优的同时降低码率,大大提升传输效率,保障用户体验,提升产品竞争力。

好看视频是百度短视频旗舰品牌,全面覆盖知识、美食、生活、健康、文化、游戏、影视等海量视频。在如此大体量、多类型内容的短视频平台,好看视频借助微帧WZ265智能编码引擎,构建视频自适应智能转码,大幅降低了视频带宽CDN成本,有效平衡视频码率与视频画质,提升用户体验。
奇虎360是中国领先的互联网安全软件与互联网服务公司、致力于通过提供高品质的免费安全服务,为中国互联网用户解决上网时遇到的各种安全问题。旗下不仅有360安全卫士、360手机卫士等产品,更有快剪辑、快资讯、花椒直播等现象级产品。微帧科技为360提供智能编码方案,赋能旗下多条业务线,为360视频业务保驾护航。
百度数字人当前有上万个直播间,面临着较大的带宽成本,在接入微帧GPU视频硬编优化引擎后,仅利用GPU空余算力,在确保原有编码速度及相同画质的前提下,视频码率从原来3M降至2M,码率节省约33%。此外,针对数字人直播场景高清画质的诉求,例如生成人脸相对模糊等情况,在进入编码前,引入了人脸增强算法与算法模块相结合,在保证压缩率和实时性的前提下,进一步优化画质。
在某省电力巡检项目中,某知名硬件厂商部署了 2,000 至 3,000 台布控球及压缩盒子等前端设备。面对偏远地区网络环境差、传统算法带宽压力大等痛点,亟需在不更换硬件的前提下实现传输性能的质变。微帧将领先的极致压缩算法深度适配于现有硬件体系,包括基于 Rockchip RK3588 的压缩盒子及基于 HiSilicon DV3516 的布控球。通过软硬一体的深度优化,在维持视觉无损的前提下,实现视频码率高达 8 倍的压缩效率。
媒体处理服务可以转换媒体格式和清晰度,适应不同终端和网络环境播放,并通过智能转码技术,实现在画质不变前提下降低码率,减少播放卡顿并节省存储和流量费用,适用于泛娱乐、电商、传媒、在线教育等行业视频场景。
输入支持编码为H264或H265的主流视频格式,输出格式支持FLV、MP4和M3U8,最大分辨率4096X4096,最大帧率为120fps。
许多因素会影响转码速度,例如输入文件的时长、分辨率、转码模版设置等。一般的作业时长为输入文件时长的0.5倍到2倍之间。
媒体处理的费用是按输出文件的时长来计费的,若您使用一进多出模板进行视频转码,则转码产生的费用将是多个输出视频的转码费用总和。
智能转码是在保证画质甚至提升画质的前提下,通过视频前处理、智能码控、内容感知编码、最佳参数匹配等多种技术对不同类型的视频做优化处理,通过降低视频码率,为客户节省存储和带宽资源,以更低的带宽给用户提供更高清的观看体验。
ROI (region of interest) encoding是一项基于感兴趣区域的视频编码技术,对图像中感兴趣的区域减少量化参数值,从而分配更多码率以提升画面质量,而对不感兴趣的区域则增加量化参数值,从而分配更少码率,在不损失图像整体质量的前提下,降低视频码率。



每一段视频的永恒数字身份证
每一段视频的永恒数字身份证
视觉无感嵌入数字水印
AI 转竖屏,保留核心内容
AI识字,一键消除
高效精准拆分长视频
智能精准筛查敏感信息
AI智能追踪,精准锁定目标
精准追位,动态投广
自动萃取视频精华
AI分析视频,高效生成精简摘要
解析视频精华,自动生成亮点封面
WZ264编码器的所有实现,均符合H.264国际标准,故能解码H.264码流的设备,也可以解码WZ264,不需要特定解码器。
AV1具有开源、免专利、压缩率高、兼容浏览器等优势,正在影响着多媒体开发和应用。
Youtube、Netflix、Amazon等都在积极的使用AV1。爱奇艺也于2020年上线了AV1,成为国内首家应用AV1的视频网站。
WZ264结合AI预处理、智能码控、编码内核优化三大模块百种工具的优化和深度打磨,做到画质质量不损失的情况下,降低30%-50%码率。
在保证压缩优势的前提下,AV1计算复杂度还是偏高的,但AV1的编码算法一直在不断优化,以libaom为例,对比标准诞生初期已经提速了数十倍。
WZ264全面支持Android、iOS、Windows、Mac、Linux,提供移动端、pc端、服务端全平台编码方案。
Aurora-AV1在编码速度上明显快于开源方案,可运用在直播服务端编码、RTC等对编码实时性要求高的场景。
提供私有化部署方案。方案粒度比较灵活,可提供智能转码程序或整套分布式转码系统,助力厂商快速搭建视频处理能力。
AV1的硬解生态处于快速发展期,近年来各厂商纷纷发布了支持AV1硬解的手机、TV、电视盒子等,如小米、三星、索尼。但还需进一步发展,目前主要依赖软解。
主要使用dav1d这款解码器,是相当优秀的开源软件解码器,微帧自测其功耗界于ffmpeg - h264 decoder与openhevc decoder之间。
像素智绘引擎是面向 AI 生成视频的全链路像素级 AI 视觉处理引擎,整合画质评测、AI 修复增强、瑕疵矫正、超分辨率、帧间稳定、AIGC 缺陷修复多模块一体化能力。 区别于单点工具:不是只做简单放大,而是语义理解 + 像素重构双路径,既能做画质打分评估,又能针对性修复 AIGC 常见问题:纹理漂移、闪烁、畸形细节、文字错乱,打通「质量检测→智能修复→输出结果」完整流水线,可嵌入生成、转码、审核、分发业务链路。
VMAF/PSNR 属于有参考评估,必须要有无损原始参考文件,多用于编码实验室对比;WZ‑VQA 是无参考画质评价,不需要原始源文件,直接对线上真实图片、UGC 短视频、AIGC 生成素材打分,更贴合真实业务生产环境。 WZ‑VQA 融合 CNN+Transformer,同时解析底层画质损伤、运动时序、美学构图、语义特征,评分更贴近普通人眼瞬时主观观感,自建数据集上 PLCC 可达 0.9328、SRCC 达 0.9368,行业领先水平。
主流手机、电视芯片下 1080P 实时超分至 4K 单帧延迟<10ms,全程稳定 30/60fps 不卡顿;自研轻量化神经网络,同等硬件算力下处理速度提升 50%,短视频、直播本地播放均可实时渲染无拖影、撕裂。
同等 VMAF 无损画质、相同编码速度前提下,点播场景码率平均节省 31.71%,直播场景平均节省 25.52%;数字人商用项目实测可实现 33% 带宽下降,不增加 GPU 算力消耗,充分利用显卡闲置冗余算力。
同等 VMAF 高清画质下,WZ264 较开源 x264 节省 34% 码率;WZ265 对比标准 x265 码率降低 54%;自研 Aurora-AV1 相比 SVT-AV1 节省 51% 带宽,长期可大幅削减 CDN、服务器存储支出。1080P 标准测试片源,SVT-AV1 原始 2320kbps,Aurora-AV1 仅需 1157kbps,画质无肉眼损失。
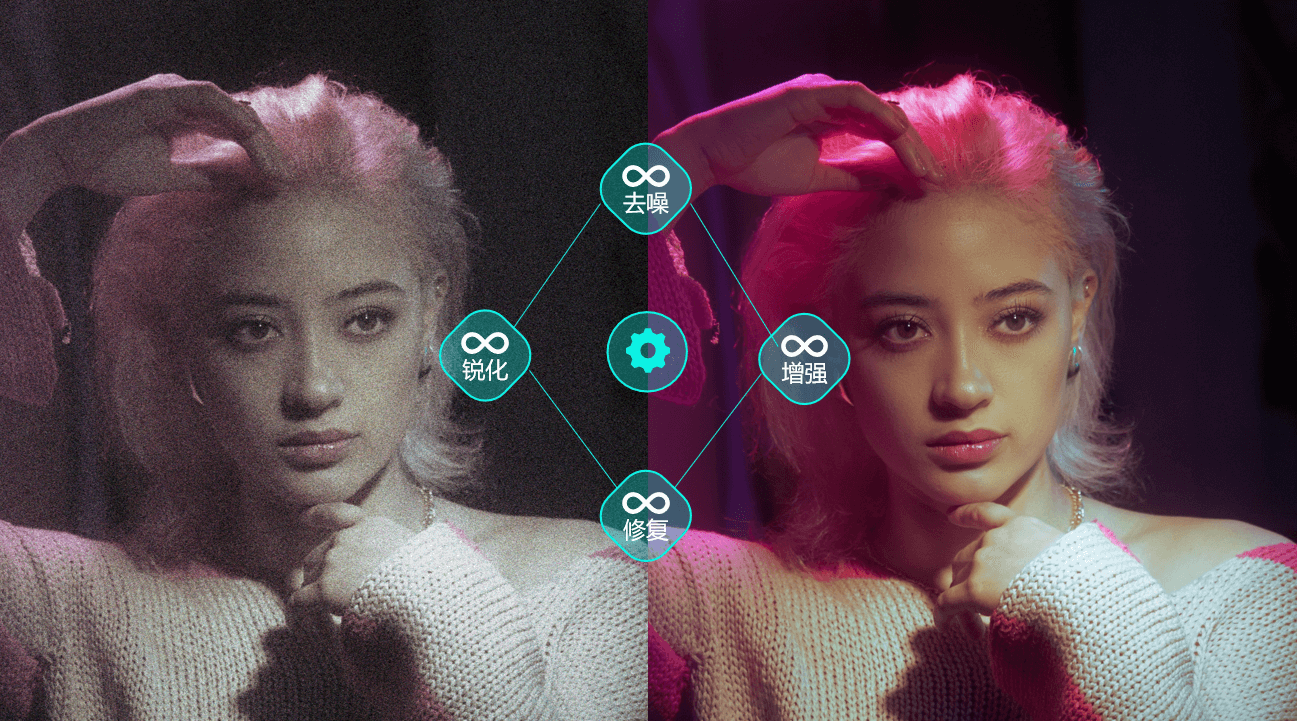
针对 AI 生成视频的特有缺陷做专项优化: 1. 细节缺失:补全低分辨率生成视频的缺失高频纹理、光影信息; 2. 人像塑料感:还原皮肤微纹理、明暗层次,消除 AI 人像常见的 “薄膜光滑感”; 3. 帧间不稳定:跨帧特征对齐,改善发丝、服装、人物轮廓漂移,抑制画面闪烁、光影跳变; 4. 错误纹理抑制:识别文字、图形畸变瑕疵,优化字形与符号,保持帧间文字位置形态稳定; 引擎会区分运动区域、静态区域,动态调整优化强度,兼顾画面自然度与时序稳定性。
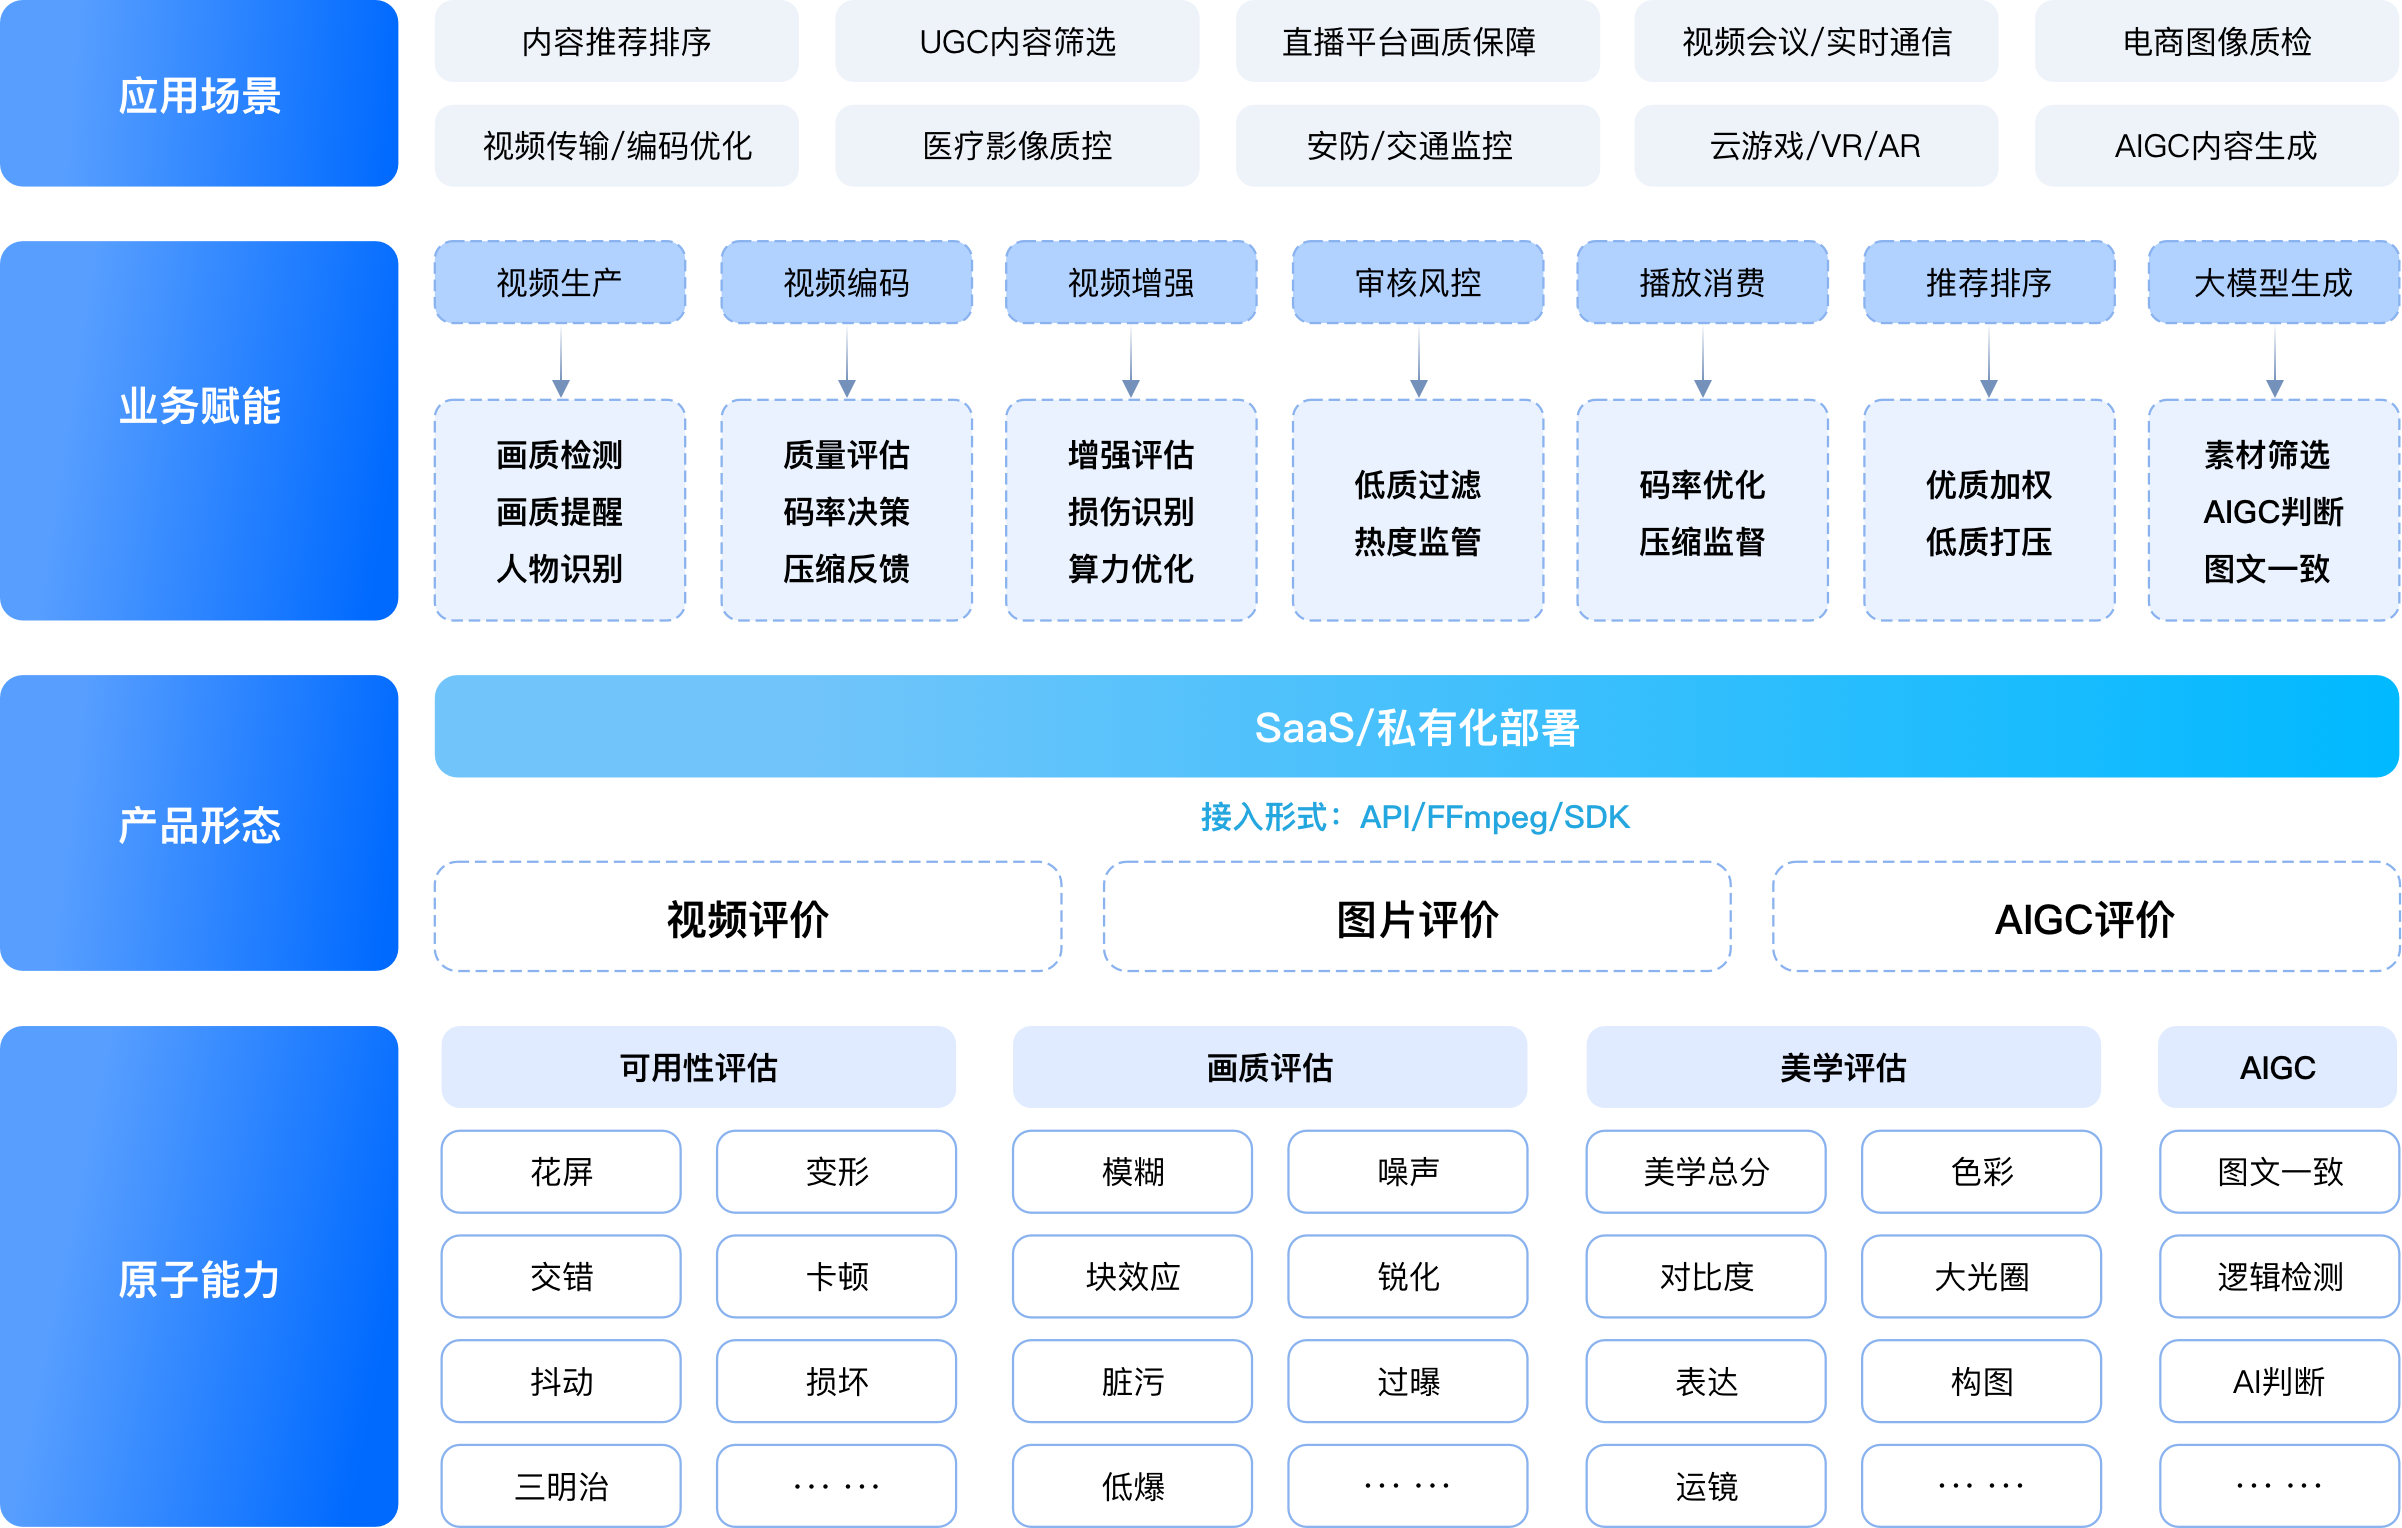
分为四大类原子评估能力,返回综合总分 + 分项明细指标: 1. 可用性评估:花屏、卡顿、交错、抖动、画面损坏等可用性故障; 2. 画质损伤评估:模糊、噪声、块效应、过曝、锐化异常等画质瑕疵; 3. 美学评估:色彩、对比度、构图、运镜、美学总分; 4. AIGC 专项评估:AI 生成浓度、图文描述一致性、逻辑异常检测。 全部指标支持业务侧自定义权重策略,适配不同行业标准。
独创端侧低功耗推理架构,相比通用 AI 画质方案整体功耗降低 60%,CPU/GPU 占用大幅下降,长时间观影温升控制良好,手机、便携平板续航几乎不受明显影响,AR 眼镜等微型设备也能长时佩戴。
不会。内置CAE 内容感知编码 + VQA 无参考画质评估双 AI 模块,自动识别人脸、游戏 UI、商品画面等高关注度区域优先保画质;天空、纯色背景适度压缩,杜绝马赛克、人脸模糊、文字发灰问题。
不会。微帧视频智能编码引擎搭载 CAE 内容感知编码 + ROI 重点区域保护算法,自动识别人脸等高关注度区域优先保留画质;对天空、纯色背景等低敏感画面进行重点压缩降噪。
原生直接输出高分辨率 AIGC 视频,需要消耗大量 Token 与算力;一旦生成出现瑕疵,往往需要整条视频重新生成,重试会带来巨大资源浪费。 像素智绘引擎支持业务优先使用较低规格模型生成原始视频,再交由引擎完成超分、细节重构、瑕疵修复。 1. 减少高规格大模型的调用占比,降低 Token 消耗; 2. 局部瑕疵无需整条视频重新生成,仅在后处理环节完成修复; 实测部分场景可降低约 30% 的生成资源消耗,生产规模越大,算力、时间、人工成本节约效果越明显,解决高质量 AIGC 内容 “做得出来,也做得起” 的痛点。
四大核心落地场景: ①视频编码 & 画质增强:编码前后做效果评估,辅助码率决策,量化增强收益; ②UGC 内容筛选:自动过滤低质投稿,降低人工审核压力; ③AIGC 内容质量优化:生成后自动质检、筛选训练数据集; ④内容推荐排序:把画质评分作为排序特征,打压低质内容,优先分发高质量素材。 可无缝嵌入转码、增强、审核、分发全业务链路,支持和 FFmpeg、现有业务流水线对接。
移动端适配高通骁龙、联发科天玑全系列 NPU/GPU;电视适配晶晨、瑞芯微、海思电视 SoC;车载支持地平线、黑芝麻车规芯片;AR / 手表微型低功耗 MCU 全覆盖,全平台统一 API 无需多套适配。
原生硬编仅基础码控;微帧在芯片硬件编码底层叠加自研 AI 管线:画质增强→ROI 重点保护→智能码率调控,在不提升硬件负载的前提下,大幅提升压缩效率与画面观感。
离线批量转码支持千万级素材队列异步处理;直播实时编码端到端最低 30ms 超低延迟,电竞赛事、秀场、电商大促直播高并发场景稳定不丢帧。
核心面向 AIGC 视频工业化生产场景: 1. AI 短剧(首个落地场景):大量快速产出镜头,保障连续剧集内人物形象稳定,修复成片细节瑕疵,减少重复生成、人工修片工作量; 2. 数字人视频生产:优化数字人面部质感,抑制口播过程中的帧间闪烁、纹理漂移; 3. AIGC 内容平台 / 素材生产平台:文生视频、图生视频生成后做标准化后处理,提升素材可交付率; 4. 也可与视频编码链路结合,将编码之后的终端观看效果纳入优化考量,在有限码率下优先保留主体视觉信息。
支持高度业务化定制: 1. 指标权重自定义:可调整可用性、画质、美学、AIGC 模块的总分权重,比如电商场景侧重清晰度,短视频平台侧重美学观感; 2. 自定义判定阈值:可以配置低分拦截、告警阈值,例如 “综合分低于 3.5 自动拦截发布”; 3. 垂直场景专项调优:针对电商商品图、短剧、直播、AIGC 生成视频做专项模型微调优化; 4. 输出字段按需裁剪,适配业务系统需求微帧科技。
在线低码流视频终端实时高清化,无需云端加高码率,平台 CDN 带宽成本降低;人脸、字幕智能锐化,提升完播率,抖音、视频号类播放器均可快速集成。
GPU 端全系列 NVIDIA 显卡(T4/RTX30/40 系 NVENC);国产嵌入式 SOC 覆盖瑞芯微 RK3588/RK3568/RV1126、海思 Hi3516/Hi3536,云端服务器、边缘布控球硬件均可适配。
主流短视频平台落地实测带宽、存储综合成本下降 40%-50%,美妆、美食类视频经 Pseudo-HDR 色彩优化,提升用户播放留存,小红书、好看视频等头部平台均已规模化落地。
提供多种交付形态,适配不同企业 IT 架构: 1. 公有云 API:REST 接口,支持同步 / 异步任务,可直接嵌入 AIGC 生成流水线,上传视频资源或者传入资源 URL,返回优化后视频文件; 2. 服务端 SDK:可集成到客户本地生产系统、转码服务,适合批量短剧、数字人生产任务; 3. 私有化部署:完整模型与引擎部署至客户内网,全部视频素材处理、推理均在客户机房内完成,满足数据不出域的合规诉求。 同时支持和现有 AIGC 大模型做兼容对接,不绑定特定的文生视频模型。
AIGC 专项模块包含两大核心能力: 1. AI 生成来源判别:输出 AI 浓度分值,判别素材为 AI 生成 / 真人实拍; 2. 图文一致性校验:比对画面和原始 Prompt 文本的匹配度,输出一致性分数,识别画面逻辑错误、物体畸形、图文不符等 AIGC 常见瑕疵。 多用于 AIGC 平台发布前自动质检、大模型训练数据集清洗、生成效果自动化评测场景。注意:不保证 100% 识别全部 AI 伪造,建议搭配业务规则、人工复核做闭环流程微帧科技。
大屏专属 HDR 色彩映射算法,运动画面插帧消除拖影,暗场电影细节提亮;天猫精灵哇哦闺蜜机已规模化落地,原生适配大屏 UI 与长时间待机功耗控制。
可以,无需替换前端硬件盒子、布控球。算法深度适配原有芯片硬编模块,固件 / SDK 轻量化对接。
内置智能动态码控,根据用户网络实时调节码流;游戏高动态画面保留细节,电商商品纹理不模糊,虎牙、支付宝直播大型活动全程稳定流畅。
引擎解决的是 AI 生成视频视觉层缺陷:清晰度、纹理质感、帧间闪烁漂移、人像观感等问题; 对于剧情、构图、创意、人物动作逻辑这类内容层面问题,算法无法替代人工。 在短剧等真实生产链路中,像素智绘引擎可以大幅降低人工修片、重复生成的工作量,把大量不合格素材修复至可交付标准;极少数重度内容逻辑异常的镜头,仍需要人工介入调整或重生成。
支持图片、短视频、长视频、AIGC 文生图 / 文生视频全部素材类型。 - 图片:JPG、PNG、WebP 等主流格式; - 视频:点播长短视频、直播切片,支持 H.264、H.265、AV1 等编码; - AIGC 专项能力:可输出 AI 生成浓度、图文一致性分数,识别 AI 生成常见缺陷,适配 AI 生成内容质检、训练集清洗场景
完全符合车规级稳定标准,逆光、隧道暗光监控画面自动提亮降噪,超低延迟保障倒车实时可视;极低负载不占用车载主控算力,不影响整车电气负荷。
针对游戏 UI、人物、特效做 ROI 区域强化,动态区分战斗高光与静止背景;高帧率画面保留流畅度,大幅降低云端推流带宽,玩家端无拖影、卡顿。
1、同等画质码率节省 30%-54%; 2、针对短视频 / 直播 / 教育 / 监控做场景 AI 预优化; 3、编码速度快 3.2 倍; 4、提供商业技术支持、专属场景调优与私有化授权,开源无专人售后迭代。
百度数字人万级直播间落地实测,同等高清人脸画质,码率从 3M 降至 2M,节省 33% 带宽;内置人脸增强模块,解决数字生成人脸模糊痛点,全程复用渲染闲置 GPU 算力,无额外算力开销。
提供免费场景定制调优,技术工程师根据平台内容类型(美妆 / 游戏 / 课件 / 监控)调试专属 CRF、码控、HDR 参数,最大化平衡画质与带宽成本。
复用训练空闲 GPU 算力批量压缩原始训练片源,无需额外转码服务器,海量素材存储容量大幅缩减,压缩后不丢失画面特征,不影响模型训练精度。
支持 MP4、TS、MOV,适配 RTMP/HLS/WebRTC 全直播协议;服务端 Linux/Windows/macOS、移动端 Android/iOS、嵌入式边缘设备全覆盖;老旧低版本设备可自动降级输出 H.264 流,不会出现黑屏无法播放。
免费提供场景专属调优,针对云游戏、数字人、安防、AI 训练素材分别优化码控、画质增强参数,最大化平衡带宽、算力、画面清晰度。
提供私有化部署方案及云端部署方案。方案粒度比较灵活,可提供编码库、智能转码程序或整套分布式转码系统,助力厂商快速搭建视频处理能力。

微帧Visionular是全球领先的视频编码及视频AI服务提供商,基于AI+视频技术,致力于为企业提供低成本、超高清、智能化的视频服务。
微信:Visionular_mkt
邮箱:mkt@visionular.com

扫码关注微帧
微帧科技 © 2026 浙ICP备19012786号 浙公网安备 33010602011989号